OpenThai 2.0 Legal ขึ้น TH-AI Passport แล้ว: โมเดลกฎหมายไทยที่ตอบพร้อมบอกมาตรา
OpenThai 2.0 Legal เพิ่งขึ้นแพลตฟอร์ม AiPASS ของกระทรวงดิจิทัลเพื่อเศรษฐกิจและสังคม (DE) ใครมี TH-AI Passport ลองได้เลย จุดต่างจากโมเดลทั่วไปคือมันตอบคำถามกฎหมายพร้อมบอกว่าอยู่ พ.ร.บ. ไหน มาตราอะไร โดยค้นจากตัวบทจริงกว่า 2,000 ฉบับ ไม่ได้ตอบจากความจำอย่างเดียว และเป็นโมเดลแบบ open-weight ที่ดาวน์โหลดไปรันเองได้
ทำไมประเทศไทยต้องมีโมเดลกฎหมายของตัวเอง
ไอเดียนี้มาจากตอนที่ทีมเราทำ น้องทนอย ผู้ช่วยค้นกฎหมาย แล้วพบว่าโมเดลจากต่างประเทศตอบคำถามกฎหมายไทยได้ไม่แม่น โดยเฉพาะเรื่องที่สำคัญที่สุดในงานกฎหมาย คือการอ้างอิง: เรียกชื่อกฎหมายผิด หรืออ้างมาตราที่ไม่ใช่ ประเทศไทยจึงควรมีโมเดลที่เก่งกฎหมายไทยจริงๆ และเปิดให้ทุกคนเอาไปใช้ต่อได้
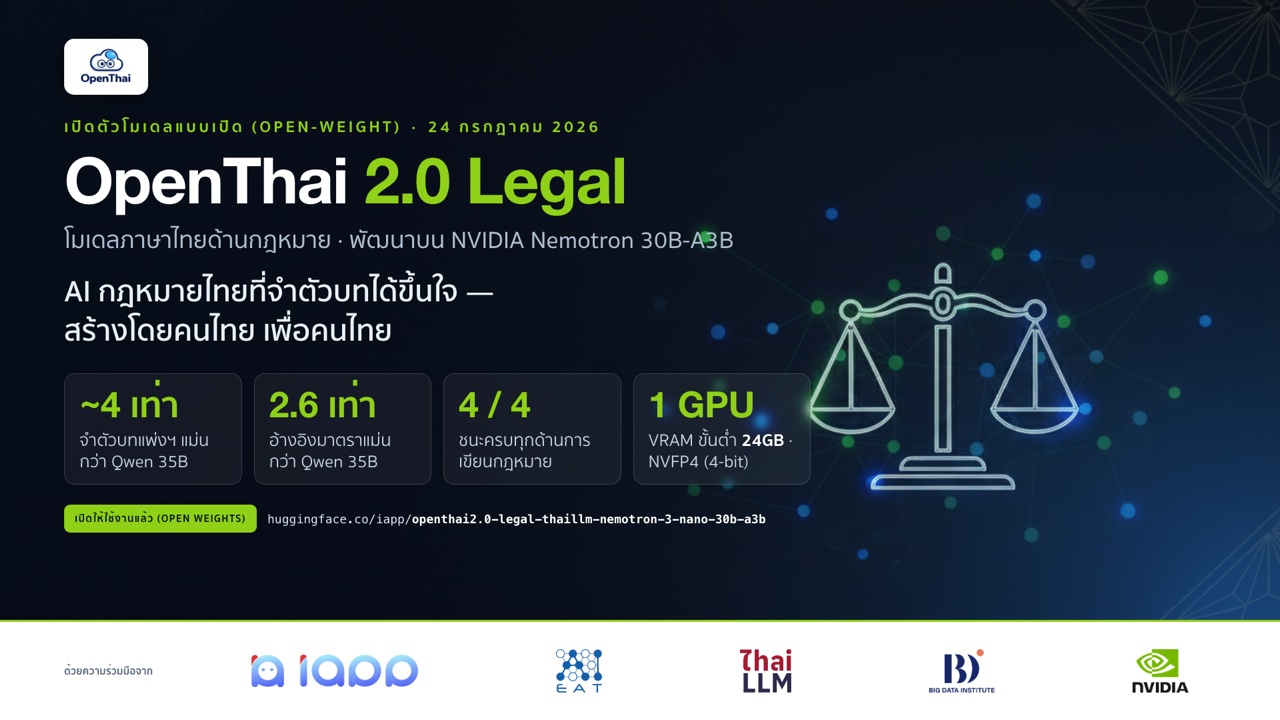
OpenThai 2.0 Legal คืออะไร
- ฐานคือ NVIDIA Nemotron 3 Nano 30B-A3B (ส่วนข้อความของ Nemotron-3-Nano-Omni-30B-A3B-Reasoning) รับข้อความ ตอบเป็นข้อความ ยังไม่รับรูปภาพ
- Mixture of Experts (MoE) พารามิเตอร์รวม 30B แต่ใช้งานจริงราว 3B ต่อ token คำถามแต่ละข้อจะปลุกเฉพาะ expert ที่เกี่ยวข้อง จึงตอบเร็วกว่าโมเดลแบบ dense ขนาดเท่ากันมาก ในคลิปผมประเมินไว้ราว 5 ถึง 7 เท่าบนเครื่องสเปกเดียวกัน
- Context ยาว 256k token เพราะเป็นสถาปัตยกรรมผสม Mamba2-Transformer ที่มีชั้น attention แค่ 6 จาก 52 ชั้น ใส่ตัวบทยาวๆ หรือคำพิพากษาหลายฉบับใน prompt เดียวได้
- พัฒนาโดยทีม OpenThai (สมาคมผู้ประกอบการปัญญาประดิษฐ์ประเทศไทย และ iApp Technology) ในฐานะส่วนหนึ่งของ Thai LLM Consortium
เหตุผลที่เลือก Nemotron เป็นฐาน คือ NVIDIA พัฒนามันบนข้อมูลโอเพนซอร์สทั้งหมด และมีความสามารถด้าน reasoning ในตัว ผมมองว่าเป็นตัวเลือกที่ดีมากสำหรับโมเดลเฉพาะทางที่ต้องใช้งานในชีวิตประจำวัน
เทรนอย่างไร: CPT → SFT → GRPO บน NVIDIA NeMo
NVIDIA มาช่วยสอนทีมเราใช้ NeMo Stack ชุดเครื่องมือที่ NVIDIA แนะนำสำหรับปรับแต่งโมเดลให้ถูกหลัก และ optimize เป็นพิเศษบนการ์ดจอ NVIDIA การเทรนแบ่งเป็น 3 ขั้น แต่ละขั้นแก้ปัญหาคนละเรื่อง:
- Continued Pretraining (CPT) สอนตัวกฎหมาย ให้โมเดลซึมซับตัวบทและคำพิพากษาจริงจนความรู้อยู่ในน้ำหนักของโมเดล
- Supervised Fine-Tuning (SFT) สอนให้ตอบแบบมีหลักฐาน ทุกคำตอบอยู่ในรูป JSON ที่อ้างเฉพาะมาตราที่ได้รับมา
- GRPO (Reinforcement Learning) สอนความแม่นยำ ให้รางวัลด้วยคะแนน citation F1 ของ benchmark ทางการ อ้างผิดหรืออ้างขาดก็โดนหักคะแนน
ใครอยากเข้าใจแต่ละขั้นลึกขึ้น ผมเขียนไว้ในซีรีส์ LLM: Continue Pretraining, SFT + LoRA และ GRPO
ผลทดสอบ
ตัวเลขจาก model card บน Hugging Face คะแนน 0 ถึง 1 ยิ่งสูงยิ่งดี ข้อที่เป็นการอ้างอิงใช้ตัวให้คะแนน citation F1 ของ NitiBench ส่วนเรียงความกฎหมายให้ Gemini 3.1 Flash Lite เป็นผู้ตรวจ
| การทดสอบ | OpenThai 2.0 Legal | Qwen3.6-35B | Nemotron-3-30B (ฐาน) |
|---|---|---|---|
| ตอบจากความจำ: จำประมวลกฎหมายแพ่งและพาณิชย์ (n=3,729) | 0.07 | 0.02 | 0.001 |
| ตอบจากความจำ: จำประมวลรัษฎากร (n=50) | 0.40 | 0.36 | 0.31 |
| มีตัวบทให้ (RAG): อ้างมาตราแพ่งฯ ที่เกี่ยวข้อง (n=3,729) | 0.99 | 0.99 | 0.98 |
| มีตัวบทให้ (RAG): เลือกเฉพาะมาตราภาษีที่ใช้ได้ จากที่ปนตัวหลอก (n=50) | 0.69 | 0.64 | 0.45 |
| เรียงความ: อ้างอิงมาตราถูกต้องในเนื้อความ (n=72) | 0.25 | 0.09 | 0.02 |
| เรียงความ: วินิจฉัยได้ข้อสรุปทางกฎหมายถูกต้อง (n=72) | 0.57 | 0.50 | 0.31 |
วิธีอ่านตารางนี้อย่างตรงไปตรงมา:
- การจำมาตราจากความจำล้วนๆ ยากมากสำหรับทุกโมเดล ตัวเลขดิบจึงต่ำ แต่ในข้อแพ่งฯ OpenThai 2.0 Legal จำได้ราว 4 เท่าของ Qwen3.6-35B
- เมื่อมีตัวบทให้ (โหมด RAG) อ้างอิงได้เกือบสมบูรณ์ จุดที่ยังยากคือการแยกมาตราที่ใช้ได้จริงออกจากมาตราที่คล้ายกัน
- งานเขียนเรียงความกฎหมาย นำ Qwen3.6-35B ครบทั้ง 4 ด้าน (การอ้างอิง ข้อวินิจฉัย ความครอบคลุม และสำนวนภาษา)
ข้อมูลเบื้องหลังบน AiPASS
เวอร์ชันที่ให้บริการบน AiPASS มีระบบค้นข้อมูลกฎหมายต่อพ่วงอยู่ด้านหลัง ได้แก่ กฎหมายราว 2,300 ฉบับ รวมราว 68,000 มาตรา และคำพิพากษาศาลฎีการาว 13,000 ฉบับ พร้อม web search สำหรับคดีที่เป็นข่าว
โมเดลรันในประเทศไทยทั้งหมด 100% เพราะดาต้าเซ็นเตอร์ที่ใช้ตั้งอยู่ในประเทศไทย พัฒนาโดยคนไทย และใช้ข้อมูลของไทย ข้อมูลที่ถามจึงไม่รั่วไหลออกนอกประเทศ
ลองใช้บน AiPASS
- เข้า de.aipass.net ด้วยบัญชี TH-AI Passport
- เปิดหน้าต่างเลือกโมเดล เลื่อนแถบหมวดไปทางขวาสุด แล้วเลือกแท็บ AIEAT
- เลือก OpenThai 2.0 Legal แล้วเริ่มถามได้เลย
ลองทักทายก่อนก็ได้ โมเดลจะเล่าว่าทำอะไรได้บ้าง เช่น ตอบคำถามกฎหมายไทย อธิบายภาพรวมของ พ.ร.บ. หรือประมวลกฎหมาย ค้นและสรุปคำพิพากษาศาลฎีกา และวิเคราะห์ข้อเท็จจริง ตัวอย่างที่ผมลองในไลฟ์:
- "ลาออกต้องแจ้งล่วงหน้ากี่วัน" โมเดลค้นข้อมูลแล้วแยกเคสให้ เช่น กรณีลูกจ้างเอกชน และถามต่อได้ว่า "ต้องทำอย่างไร"
- "พ.ร.บ. คอมพิวเตอร์" สรุปบทบัญญัติสำคัญและสาระของกฎหมายให้
- โจทย์เรียงความ (อันนี้ลองผ่านหน้าเดโม API ของ iApp): จำเลยขีดฆ่าและฉีกเอกสารหลักฐานแห่งหนี้ แม้เอกสารยังอ่านได้ ถือเป็นความผิดสำเร็จหรือเป็นเพียงการพยายามกระทำผิด ระบบดึงตัวบทกฎหมายอาญาที่เกี่ยวข้องมาก่อน แล้วโมเดลเขียนเหตุผลทางกฎหมายให้ครบ แยกความผิดสำเร็จกับการพยายามกระทำผิด และเลือกบทมาตราที่ใช้
ลองถามเรื่องใกล้ตัวดูครับ เช่น "ผู้เช่าไม่จ่ายค่าเช่า เจ้าของบ้านบอกเลิกสัญญาได้เมื่อไหร่" AiPASS เทียบหลายโมเดลได้ในที่เดียว ลองถามคำถามเดียวกันกับโมเดลอื่นแล้วมาเล่าให้ฟังหน่อยว่าต่างกันอย่างไร ทีมเราอ่านทุกฟีดแบ็ก
รันเองบนเครื่อง
เป็นโมเดลแบบ open-weight จึงดาวน์โหลดไปรันเองได้ ทางที่ง่ายที่สุดคือ Ollama:
ollama run openthai/openthai-2.0-legal
- 4 บิต (GGUF): ใช้ RAM/VRAM ราว 24 GB รันบน RTX 4090 หรือ 5090 ได้สบาย หรือบน Mac ที่มีหน่วยความจำราว 24 GB
- 2 บิต: ผมเคยลองรัน ใช้หน่วยความจำราว 12 GB ความแม่นยำลดลงนิดหน่อยแต่ยังใช้งานได้
- ความละเอียดเต็ม (BF16): ให้บริการด้วย vLLM บน GPU 80 GB หนึ่งใบ หรือ GPU 40 ถึง 48 GB สองใบ
ลิงก์ที่เกี่ยวข้อง: โมเดลบน Hugging Face · ไฟล์ GGUF · คู่มือติดตั้ง Ollama
ข้อควรระวัง
AI ไม่มีวันถูก 100% โมเดลนี้ก็ผิดพลาดได้ ผลลัพธ์เป็นข้อมูลเบื้องต้น ไม่ใช่คำปรึกษาทางกฎหมาย ก่อนนำไปใช้จริงควรตรวจสอบมาตราที่อ้างกับตัวบทฉบับปัจจุบันเสมอ กฎหมายเฉพาะทางบางด้านหรือการแก้ไขล่าสุดอาจยังครอบคลุมได้ไม่ดีนัก เพราะกฎหมายเปลี่ยนไปตามเวลา
ขอบคุณ
โมเดลนี้เกิดขึ้นได้ด้วยการสนับสนุนจากหลายฝ่าย ได้แก่ NVIDIA ที่มาสอนทีมไทยให้ fine-tune โมเดลบน NeMo, Thai LLM Consortium, สถาบันข้อมูลขนาดใหญ่ (BDI), สมาคมผู้ประกอบการปัญญาประดิษฐ์ประเทศไทย และทีมงาน iApp ทุกคน ผมภูมิใจมากที่โมเดลที่พัฒนาโดยคนไทยกำลังถูกนำไปใช้ในวงกว้าง ลองใช้แล้วติดตรงไหน หรืออยากให้ปรับปรุงอะไร คอมเมนต์ไว้ใต้คลิปได้เลยครับ