AI อ่านเอกสารไทยตัวจิ๋ว 4 MB ไม่ต่อเน็ต ไม่ใช้การ์ดจอ: OpenThai 2.0 OCR แจกฟรี คนเอาไปทำอะไรบ้าง (Kobkrit.com EP.5)
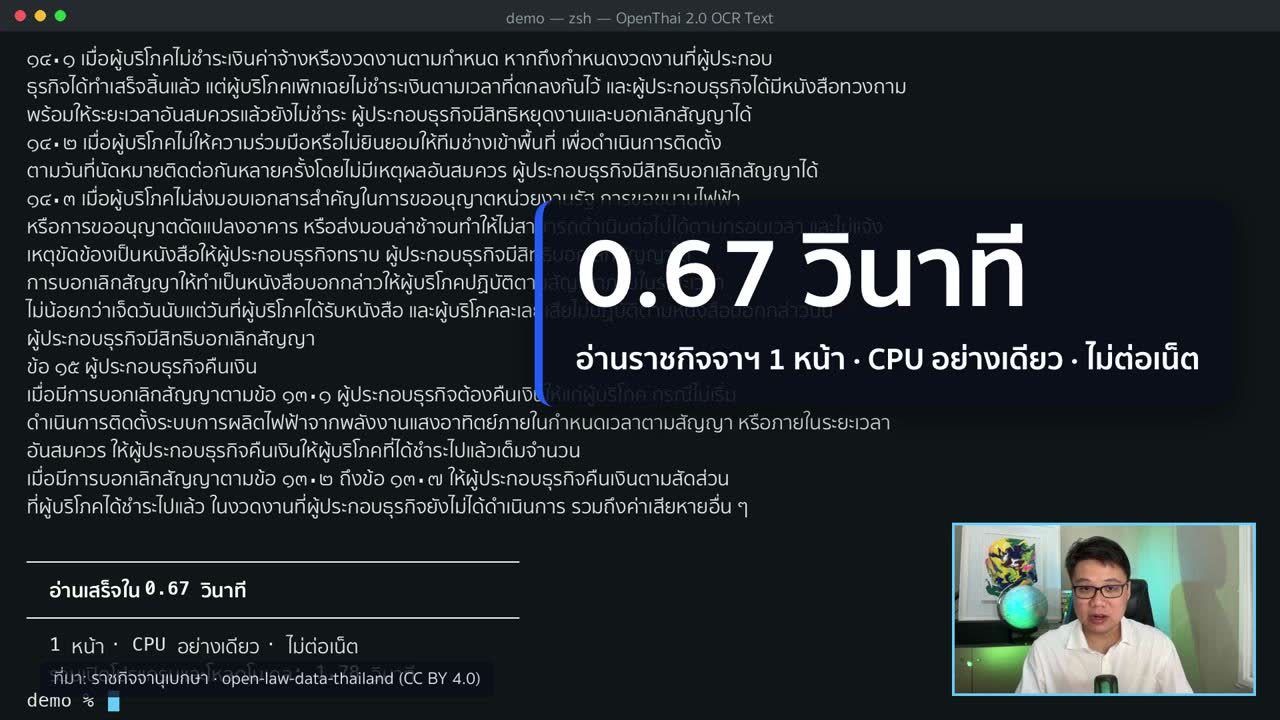
AI ตัวนี้ทั้งตัวมีขนาดแค่ 4 MB พอ ๆ กับรูปถ่ายรูปเดียวในมือถือ ปิดอินเทอร์เน็ต ไม่ใช้การ์ดจอ ใช้แค่ CPU ก็อ่านราชกิจจานุเบกษาได้ทั้งหน้าในเวลาไม่ถึงวินาที
บทความนี้สรุปจาก Kobkrit.com EP.5 (ปล่อย 15 พ.ย. 2569) OpenThai 2.0 OCR เป็นโมเดลที่ทีมผมที่ iApp ทำและแจกฟรี ตัวเลขความเร็วทั้งหมดผมวัดเองบน MacBook (M3 Max) แบบไม่ต่อเน็ต
โพสต์เดียว 4 แสนวิว
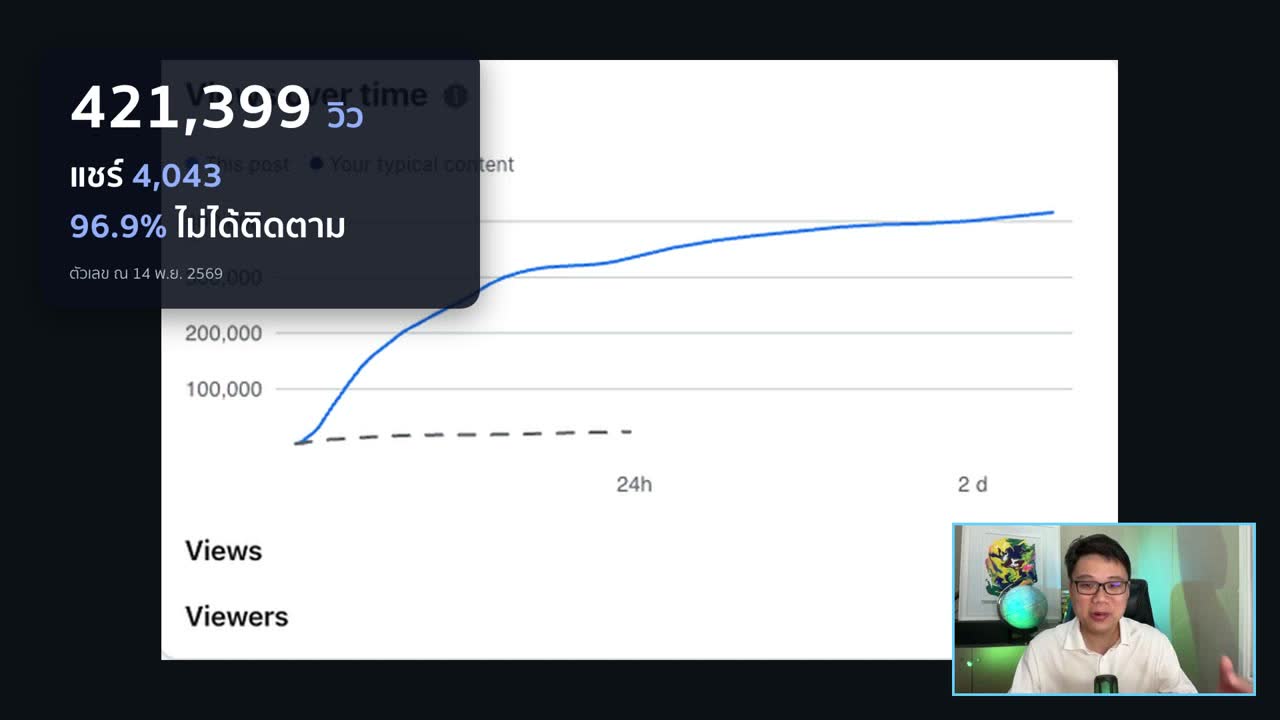
ผมโพสต์เรื่อง OpenThai 2.0 OCR ไว้ตอนเช้าวันพฤหัสที่ 12 พ.ย. ผ่านไปสองวัน มีคนเข้าไปดู 421,399 ครั้ง แชร์ 4,043 ครั้ง และ 96.9% ของคนที่เห็นไม่ได้ติดตามผมเลย มาจากการแชร์ปากต่อปากล้วน ๆ
ที่ผมไม่คาดคิดคือ แค่ 3 ชั่วโมงหลังโพสต์ก็มีคนเอาไปทำเป็นโปรแกรมแล้ว และมีโรงเรียนแห่งหนึ่งในอำเภอสะเดาทำเว็บอ่านเอกสารของโรงเรียนขึ้นมาใช้เอง
ทำไม OCR ภาษาไทยถึงยาก
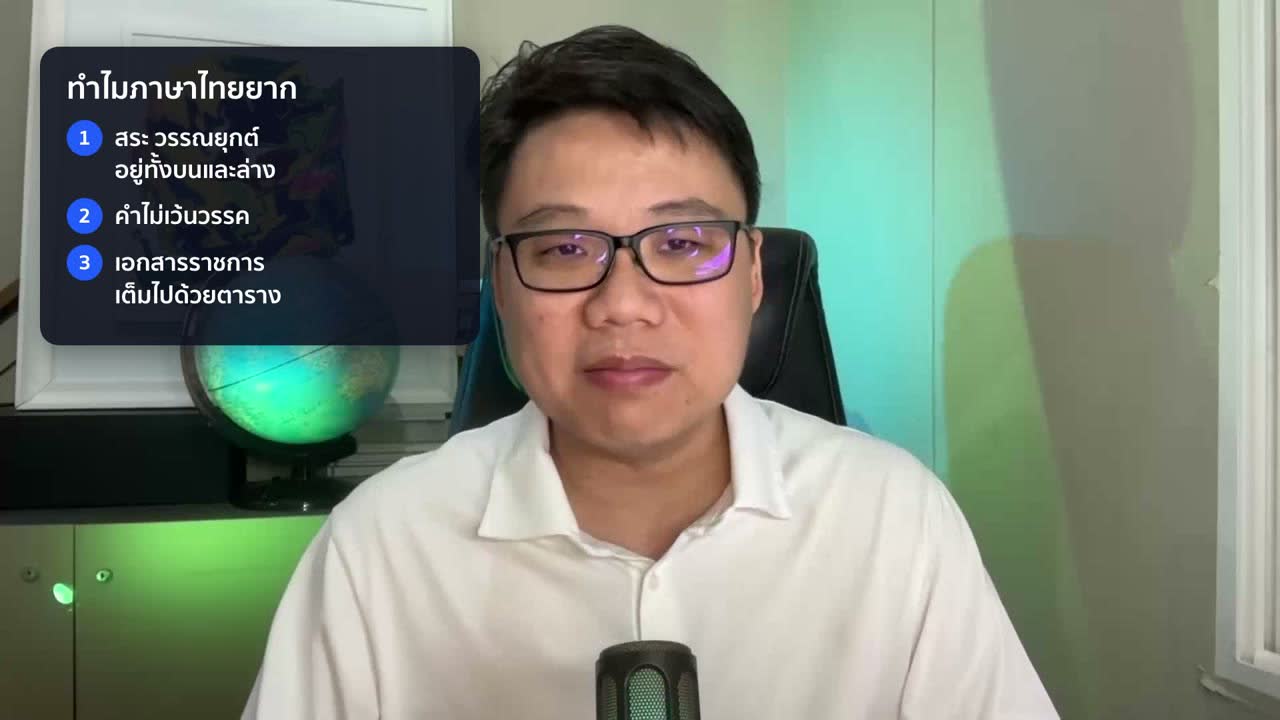
เคยไหมครับ สแกนเอกสารมาทั้งปึก แล้วอยากได้ตัวหนังสือออกมาใช้ต่อ งานนี้เรียกว่า OCR (Optical Character Recognition) คือ AI ที่อ่านตัวหนังสือจากรูปให้เรา แต่ภาษาไทยยากกว่าภาษาอังกฤษอยู่ 3 อย่าง:
- สระและวรรณยุกต์อยู่ทั้งข้างบนและข้างล่าง
- คำไทยไม่เว้นวรรค
- เอกสารราชการไทยมักเต็มไปด้วยตาราง
ตัวจิ๋ว กับ ตัวอ่านตาราง
ผมลองหน้าที่มีตารางจากเอกสารงบประมาณให้ ตัวจิ๋ว อ่าน ตัวเลขเงินถูกหมด แต่เปอร์เซ็นต์ผิด 7 ช่อง และตารางหายไปเลย ตัวเลขแต่ละช่องกลายเป็นบรรทัดลอย ๆ ใครเคยนั่งพิมพ์ใหม่ทีละช่องคงรู้ว่าเหนื่อยแค่ไหน
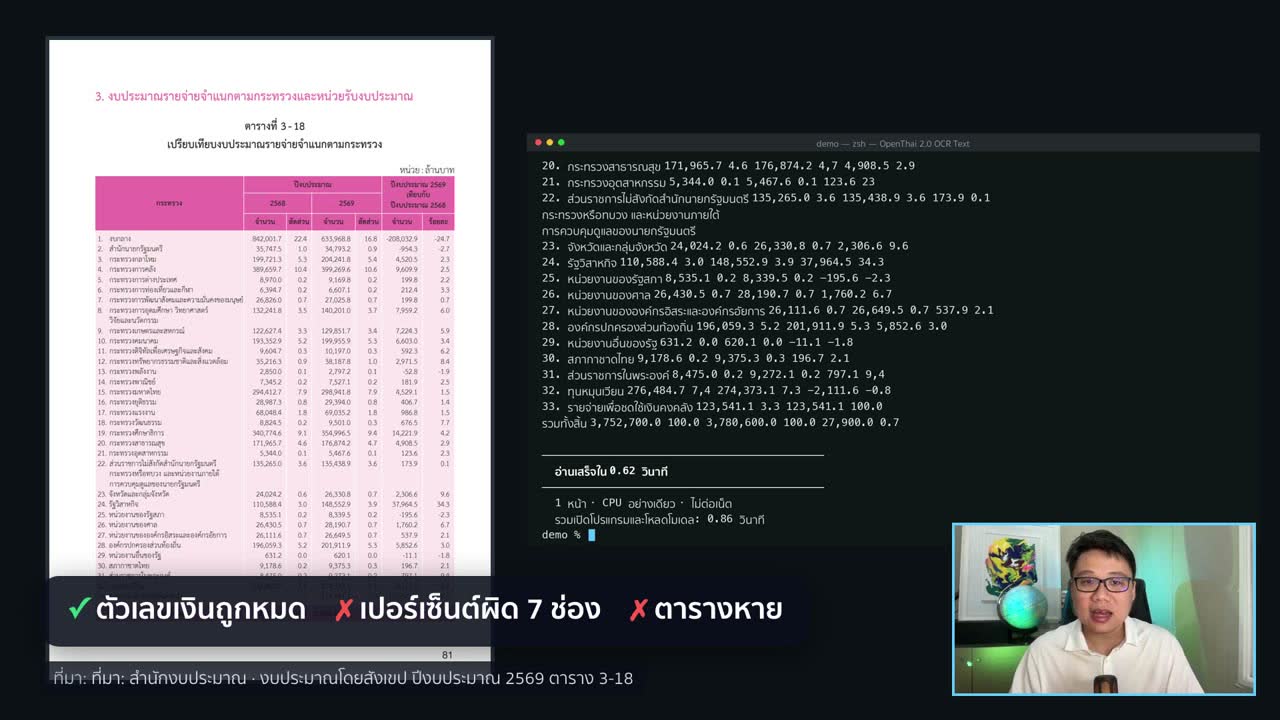
ตัวจิ๋วเก่งเรื่องเร็ว 100 หน้าใช้ราว 10 วินาที แต่ข้อเสียบอกกันตรง ๆ:
- อ่านได้แค่ตัวพิมพ์ ลายมือยังไม่ได้
- ให้แค่ตัวหนังสือ ไม่ทำตาราง
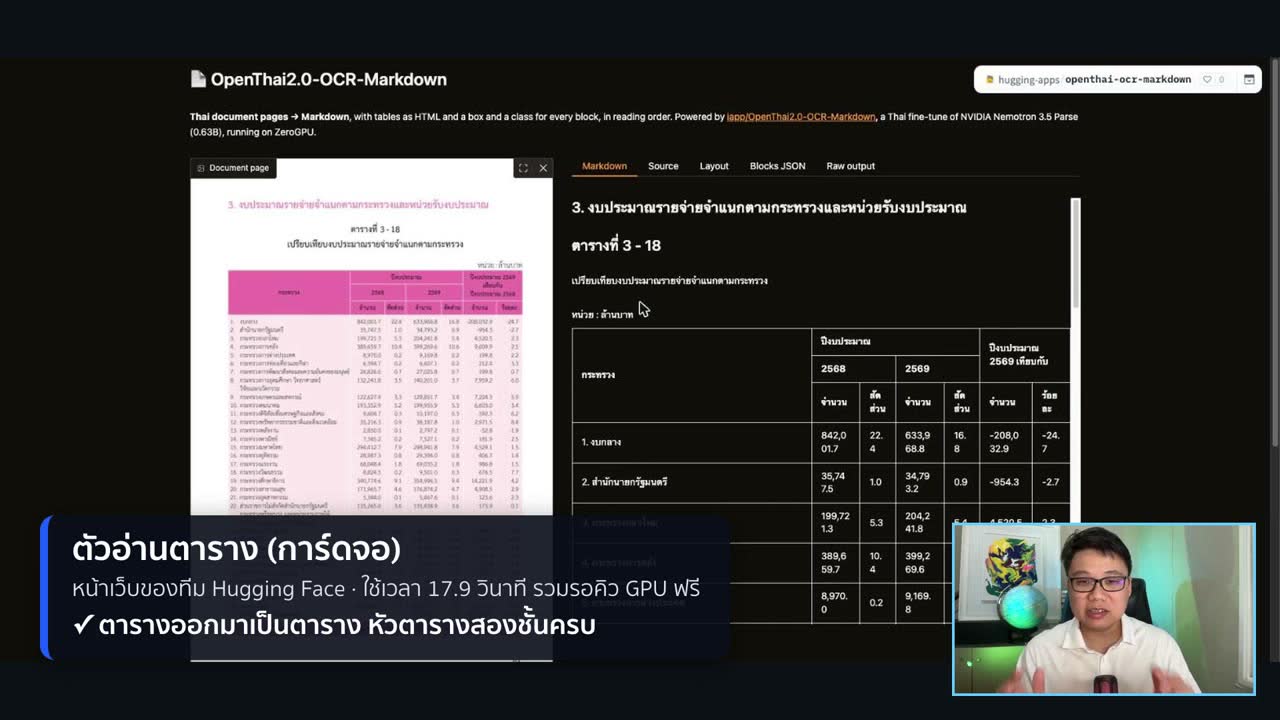
ถ้าอยากได้ตาราง ต้องใช้อีกตัวคือ OpenThai 2.0 OCR Markdown ที่ผมเรียกว่าตัวอ่านตาราง ตัวนี้ใหญ่กว่าเยอะ เลยต้องใช้การ์ดจอ แต่หน้าเดิมออกมาเป็นตาราง หัวตารางสองชั้นครบ เอาไปใช้ต่อได้เลย
| ตัวจิ๋ว | ตัวอ่านตาราง | |
|---|---|---|
| ชื่อ | OpenThai 2.0 OCR Text | OpenThai 2.0 OCR Markdown |
| ขนาด | ราว 4 MB | ใหญ่กว่าเยอะ |
| เครื่องที่ต้องใช้ | CPU ธรรมดา | การ์ดจอ |
| ได้อะไร | ตัวหนังสือ | ตัวหนังสือ + ตาราง |
| สัญญาอนุญาต | Apache-2.0 ใช้ในธุรกิจได้ | OpenMDW ใช้ในธุรกิจได้ |
ทำไมแจกฟรี: เอกสารไทยอีกหลายล้านหน้าในหน่วยงานรัฐ โรงพยาบาล และบริษัท มีข้อมูลอ่อนไหวที่ส่งไปคลาวด์ต่างประเทศไม่ได้ ผมเลยอยากให้คนไทยทุกคนใช้ AI อ่านเอกสารบนเครื่องของตัวเองได้
อ่าน 1,000 หน้าบนโน้ตบุ๊ก
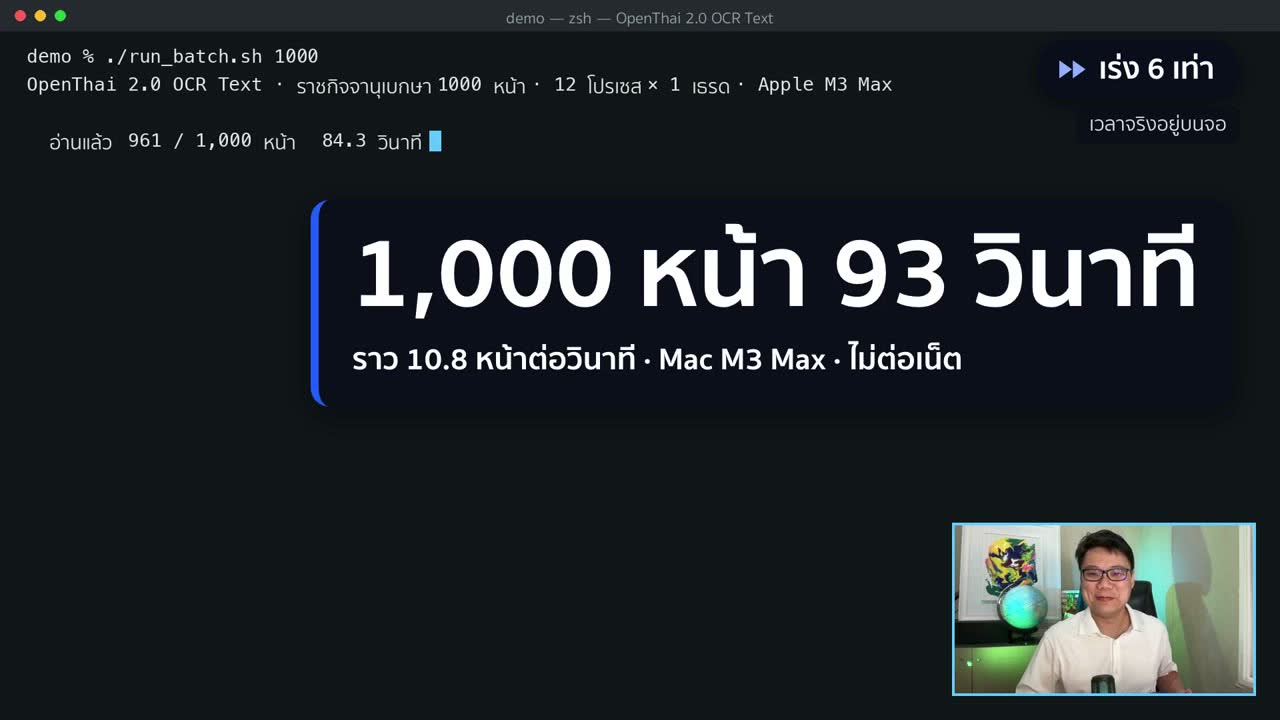
กระดาษ 1,000 แผ่นหนาประมาณนี้ ให้ตัวจิ๋วอ่านทั้งหมดบนโน้ตบุ๊กเครื่องนี้แบบไม่ต่อเน็ต ใช้เวลา 93 วินาที ตกราว 10.8 หน้าต่อวินาที
| จำนวนหน้า | เวลา |
|---|---|
| 1 หน้า | 0.67 วินาที |
| 100 หน้า | 10.2 วินาที |
| 1,000 หน้า | 93 วินาที |
วัดบน Mac M3 Max ด้วย CPU อย่างเดียว ไม่ต่อเน็ต ใช้หน้าราชกิจจานุเบกษา (100 และ 1,000 หน้ารัน 12 โปรเซสพร้อมกัน)
สองตัวนี้มาจากไหน
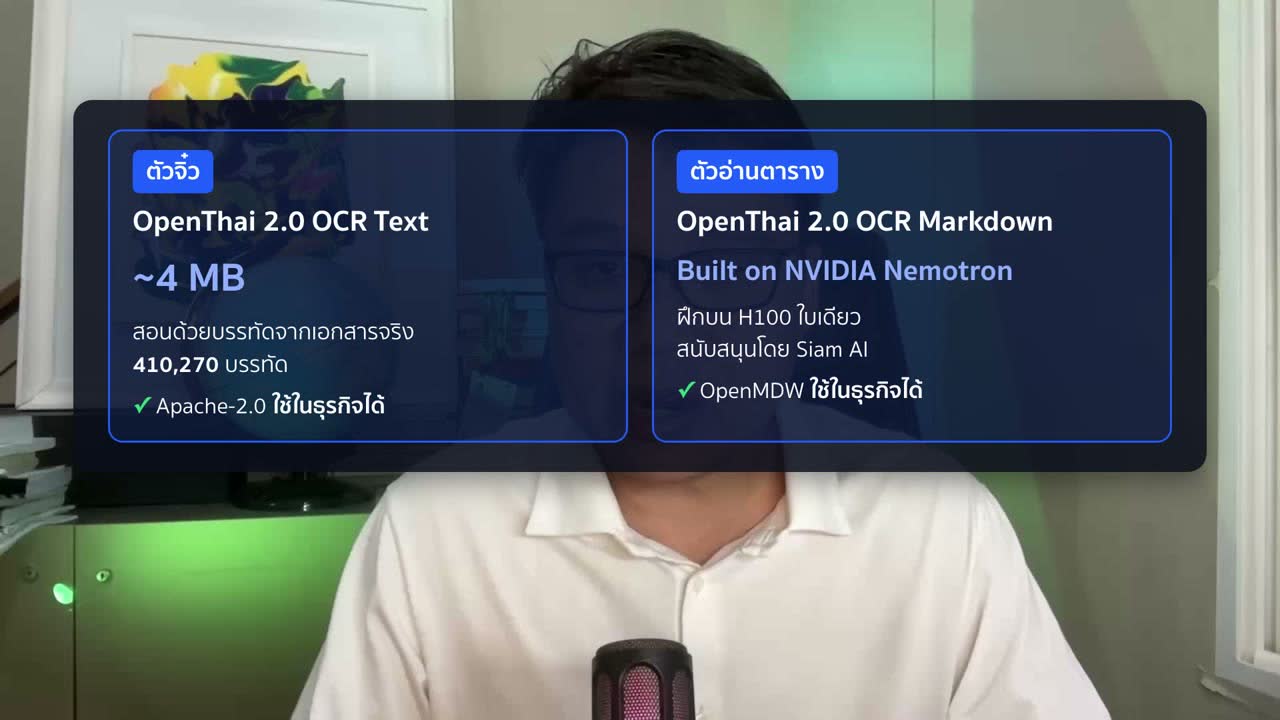
ตัวจิ๋วทีมผมสอนด้วยบรรทัดจากเอกสารไทยจริง 410,270 บรรทัด ส่วนตัวอ่านตารางต่อยอดจาก AI อ่านเอกสารของ NVIDIA (Built on NVIDIA Nemotron) แล้วสอนเอกสารไทยเพิ่ม ฝึกบนการ์ดจอ H100 หนึ่งใบที่ Siam AI สนับสนุน ทั้งสองตัวแจกฟรีและใช้ในงานธุรกิจได้
คนเอาไปลองบนเครื่องตัวเอง
หลังโพสต์ ก็เริ่มมีคนเอาไปลองใช้จริง:
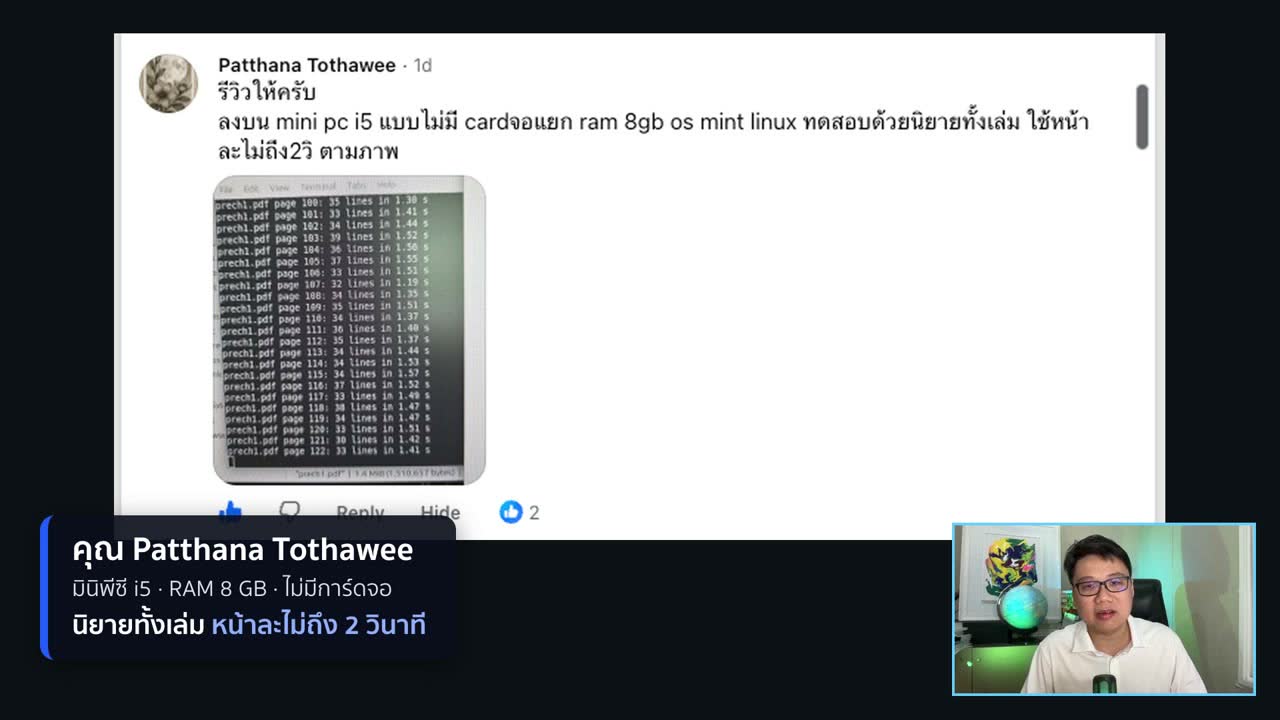
- คุณ Patthana Tothawee ลงบนมินิพีซี Intel i5 แรม 8 GB ไม่มีการ์ดจอ ให้อ่านนิยายทั้งเล่ม ได้หน้าละไม่ถึง 2 วินาที
- คุณ Wittawas ใช้เซิร์ฟเวอร์ CPU อ่านราชกิจจาฯ 5 หน้า รวมแปลง PDF ใช้เวลา 6.1 วินาที เขาบอกว่าดูด้วยตาถูกต้องราว 95–98%
- คุณ Cho Rov ลองกับเอกสารทางการ บอกว่าถูกต้องเป๊ะ แต่บทบาลียังมีจุดผิด เพราะโมเดลเทรนมาเฉพาะภาษาไทย
- คุณ Pin Kunthinee ลองกับรายงานจริงของหน่วยงาน ตัวจิ๋วได้หน้าละ 3.5 วินาทีบนโน้ตบุ๊ก แต่ตัวอ่านตารางบน CPU ล้วนใช้ราว 13 นาทีต่อหน้า ตัวอ่านตารางจึงต้องใช้การ์ดจอ
โรงเรียนในสะเดาทำเว็บ OCR ใช้เอง
ที่ผมตื่นเต้นที่สุดคือมีคนเอาไปทำของใช้จริง คุณ Korkiat Wiriyasombut ที่โรงเรียนในอำเภอสะเดา จังหวัดสงขลา ทำเว็บชื่อ "OCR เอกสารโรงเรียน" อัปโหลด PDF หรือรูป แล้วเลือกได้ว่าจะใช้แบบเร็ว (ตัวจิ๋ว บน CPU) หรือแบบตาราง (ตัวอ่านตาราง) เอกสารของโรงเรียนอ่านได้ในระบบของโรงเรียนเอง นี่แหละคือสิ่งที่ผมอยากเห็นตอนแจกโมเดลฟรี
นักพัฒนาเอาไปต่อยอด
ฝั่งนักพัฒนาไวมาก:
- anelhaman/thai-ocr โปรแกรมอ่าน PDF แบบไม่ต่อเน็ต เสร็จ 3 ชั่วโมงหลังโพสต์ (12 พ.ย. 11:00)
- wittawasw/go-open-thai-ocr-text คุณ Wittawas คนเดิม เขียนเป็นโปรแกรมภาษา Go (12 พ.ย. 12:08)
- fwgpiyawudk แปลงตัวอ่านตารางให้รันบน Mac ด้วย MLX (12 พ.ย. 17:26)
- ทีมงาน Hugging Face ทำหน้าเว็บให้ลองตัวอ่านตารางได้โดยไม่ต้องลงอะไร
- clytie0x/thai-pii-redaction เอาไปใส่ในโปรแกรมปิดข้อมูลส่วนตัวในเอกสาร
- Monaliza14xx/Lao_OCR_Toolkit ลองกับภาษาลาว
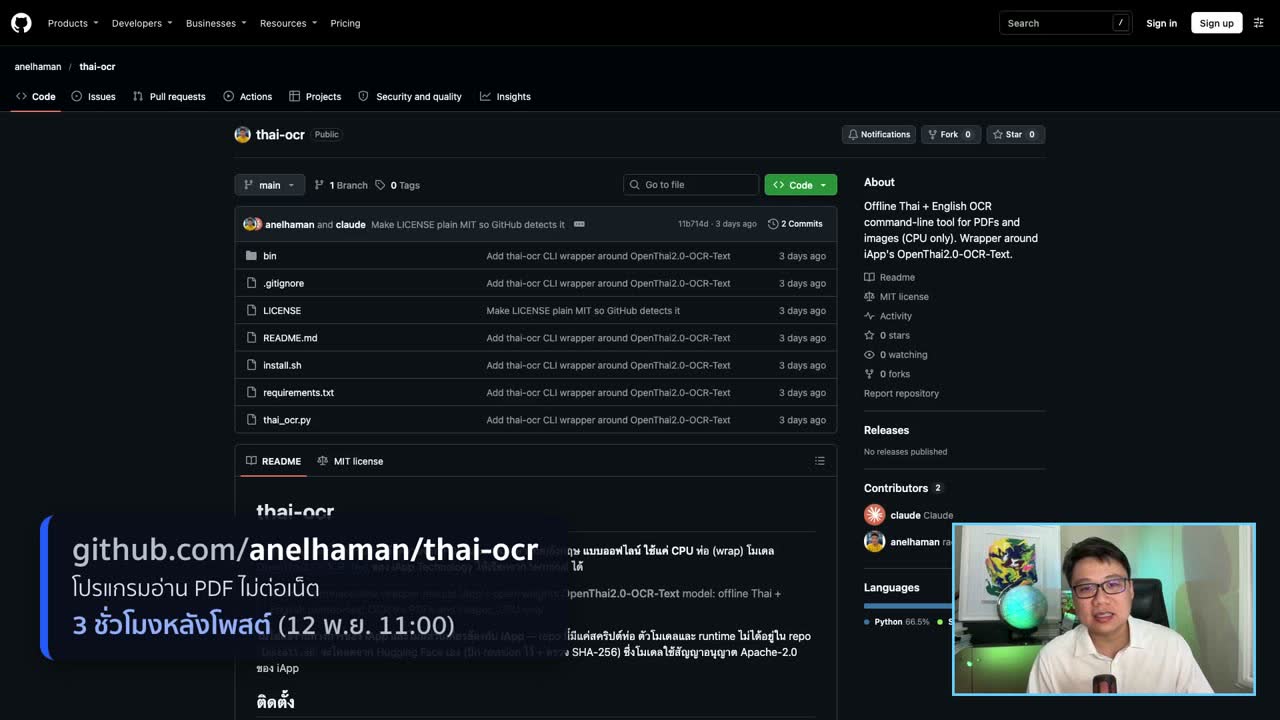
นี่แหละคือเหตุผลที่ผมแจกฟรี พอแจกออกไป คนอื่นช่วยต่อยอดให้ไปได้ไกลกว่าที่ทีมเราทำเองได้ ใครทำอะไรจาก OpenThai ส่งมาโชว์ได้ที่ openthai.ai/powered-by
ในคอมเมนต์ยังมีคนอยากเอาไปทำอีกหลายอย่าง เช่น แทน OCR ตัวเดิมในโปรแกรมที่เขียนเอง ทำ PDF จากรูปให้ค้นหาคำได้ ใช้กับสแกนเนอร์ที่บ้าน และมีคนขอคลิปสอนติดตั้ง ซึ่งผมรับไว้ครับ
ตัวถอดเสียง OpenThai
เมื่อวันศุกร์ผมปล่อยอีกโมเดลหนึ่งชื่อ OpenThai 2.0 ASR Streaming เป็นตัวถอดเสียงภาษาไทยเป็นตัวหนังสือ คุณ Mash Apinantaporn เอาไปใส่ในแอปพิมพ์ด้วยเสียงที่ใช้ฟรีชื่อ Handy พูดภาษาไทยปุ๊บ ตัวหนังสือขึ้นทันที ตัวนี้อาจจะเล่าแยกเป็นอีกคลิปครับ
ทำไมโพสต์นี้ไปไกล
เป็นโพสต์ที่ไปไกลและถูกแชร์มากที่สุดในชีวิตผม ผมว่ามี 4 ข้อ:
- ตัวจิ๋วใช้ได้ทันที ไม่ต้องมีการ์ดจอ ไม่ต้องต่อเน็ต และฟรี คนอ่านนึกออกเลยว่าพรุ่งนี้เอาไปใช้อะไร
- เป็นปัญหาที่ทุกคนเคยเจอ การพิมพ์เอกสารใหม่น่าเบื่อมาก
- บอกจุดอ่อนของตัวเองตรง ๆ เรารายงานทั้งจุดแข็งและจุดอ่อนไว้ในโพสต์ คนเลยเห็นความจริงใจ
- ชวนทุกท่านมาลอง และส่งเอกสารยาก ๆ มาทดสอบ
อยากลองเอง 3 ทาง
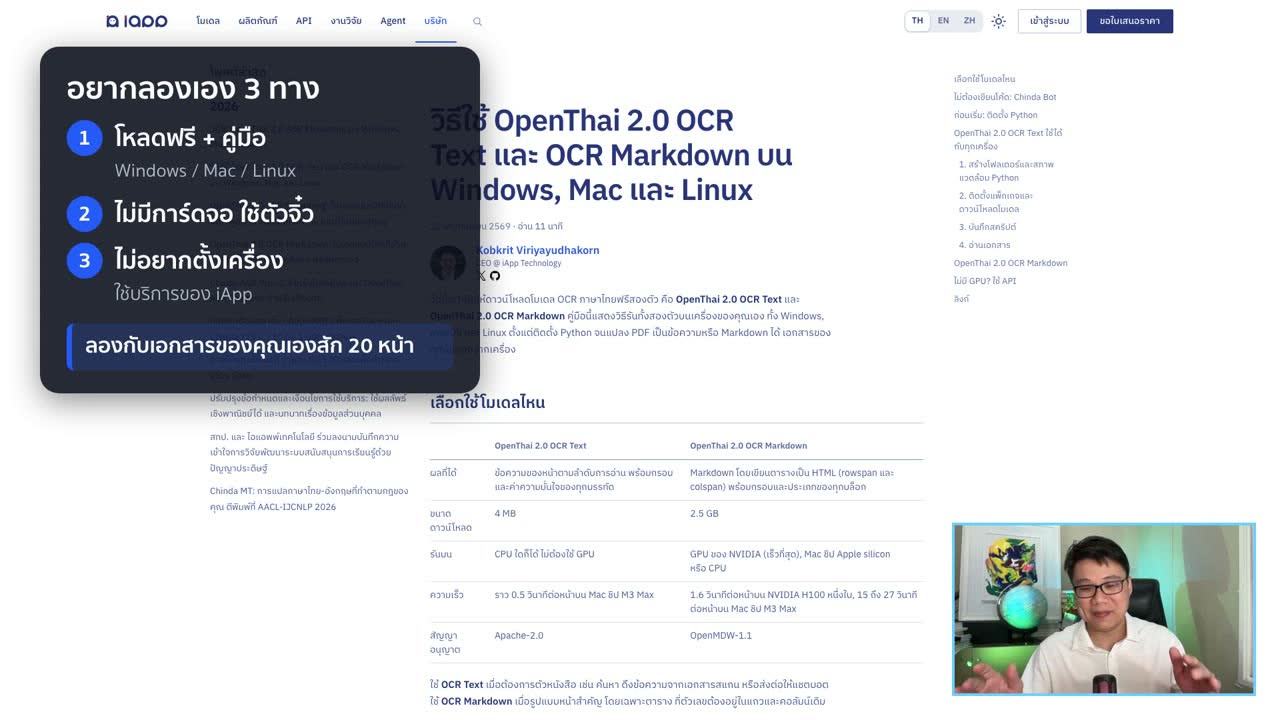
- โหลดฟรี มีคู่มือติดตั้งทั้ง Windows, Mac และ Linux
- ไม่มีการ์ดจอ NVIDIA ใช้ตัวจิ๋ว OpenThai 2.0 OCR Text รันบนคอมธรรมดาได้เลย เร็วมาก
- ไม่อยากติดตั้งหรือดูแลเครื่องเอง ใช้ผ่านบริการของ iApp
ฝากอีกข้อ: ก่อนเลือกว่าจะใช้ AI ตัวไหนอ่านเอกสาร ลองเอาเอกสารที่คุณต้องอ่านจริงสักราว 20 หน้า ไปลองกับ AI ที่สนใจ จะเป็น OpenThai หรือโมเดลอื่นก็ได้ แล้วจะรู้เองว่าตัวไหนเหมาะกับงานของคุณ
ด่านท้าทายจากคอมเมนต์
ในโพสต์ผมชวนทุกท่านส่งเอกสารยาก ๆ มา มีคอมเมนต์ร้อยกว่าอัน ส่วนใหญ่ถามว่า "อ่านแบบนี้ได้ไหม" ผมเลยลองให้ดูทีละแบบ
| ด่าน | เอกสาร | ผล |
|---|---|---|
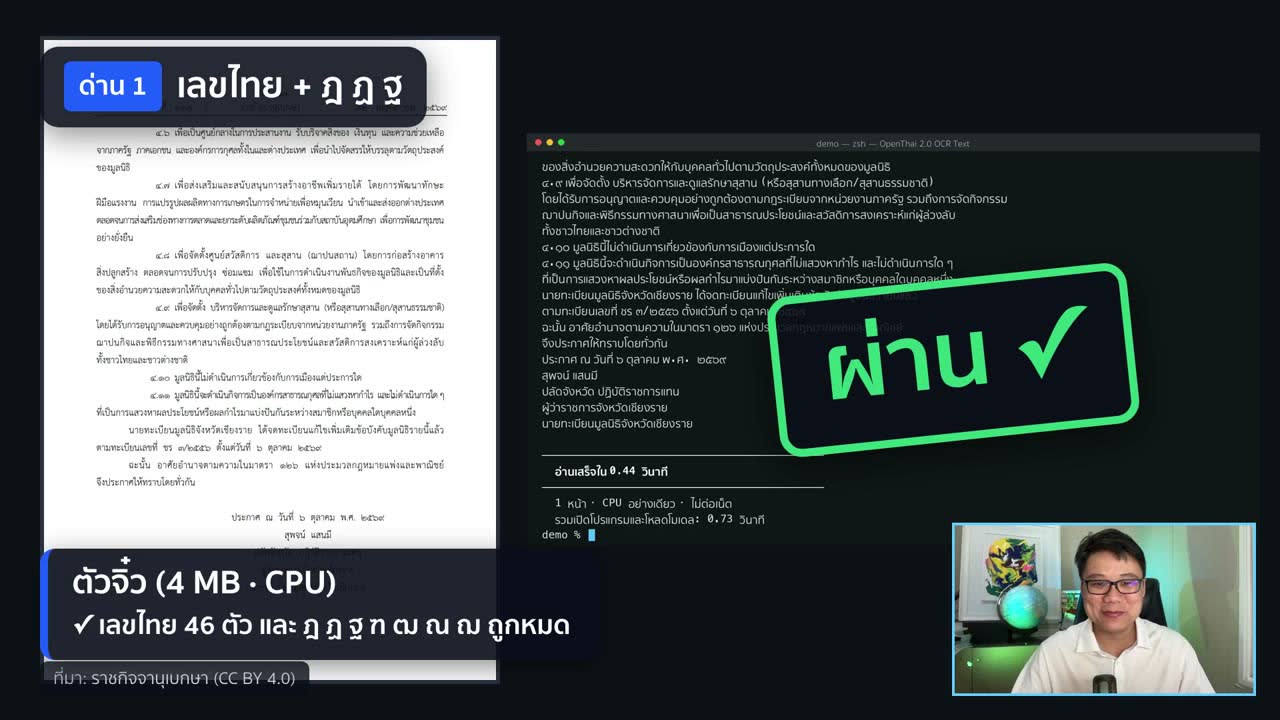
| 1 | เลขไทย + ฎ ฏ ฐ | ✅ ผ่าน: ตัวจิ๋วอ่านเลขไทย 46 ตัว และ ฎ ฏ ฐ ฑ ฒ ณ ฌ ถูกหมด |
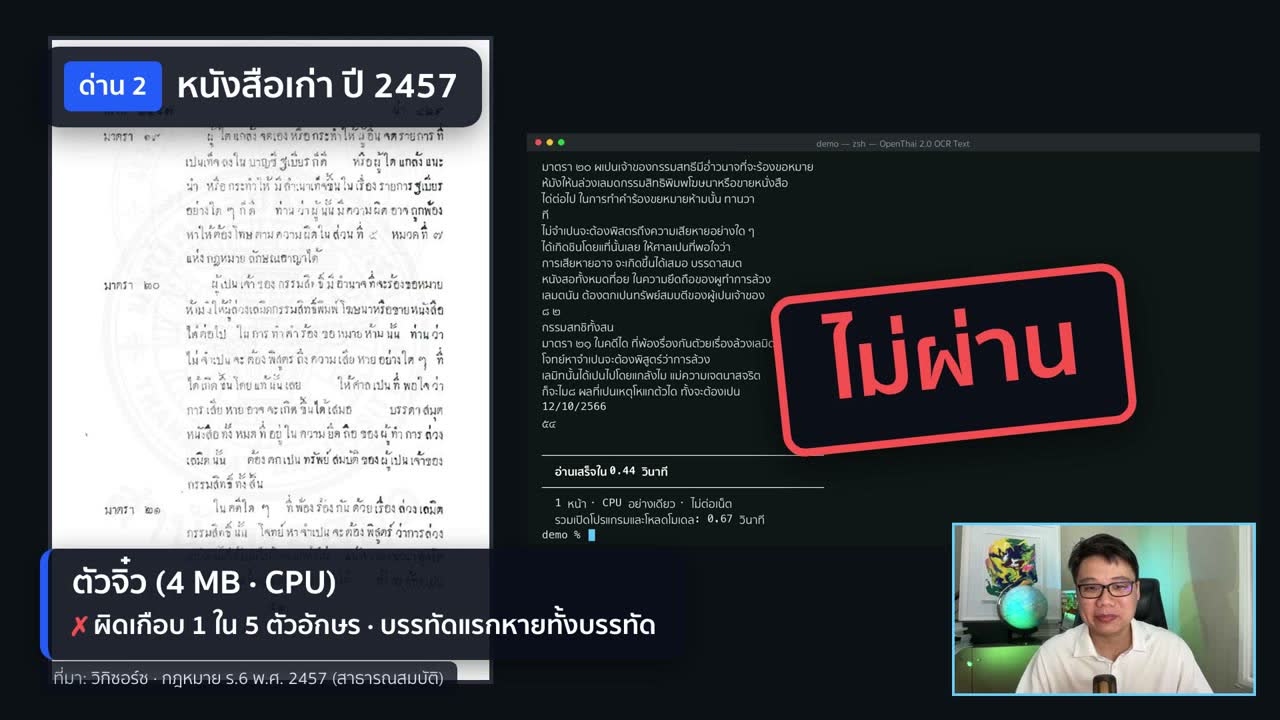
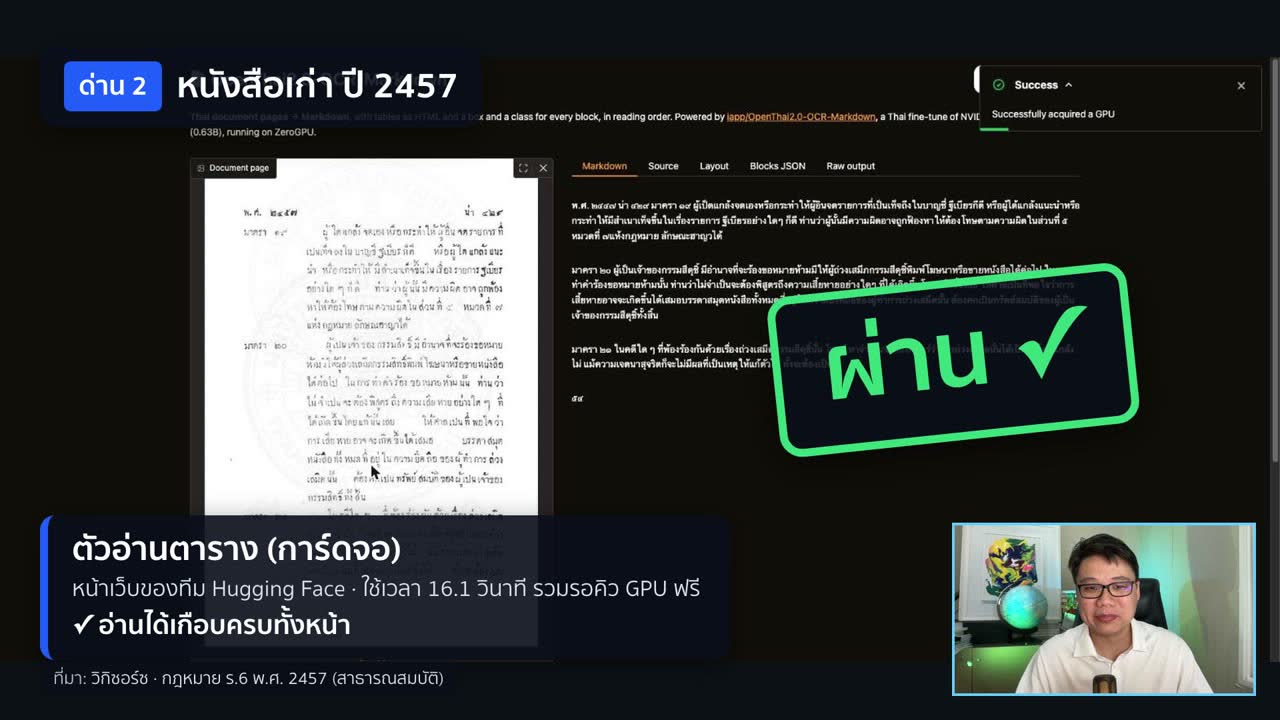
| 2 | หนังสือเก่า พ.ศ. 2457 | ❌ ตัวจิ๋วไม่ผ่าน (ผิดเกือบ 1 ใน 5 ตัวอักษร) ✅ ตัวอ่านตารางอ่านได้เกือบครบทั้งหน้า |
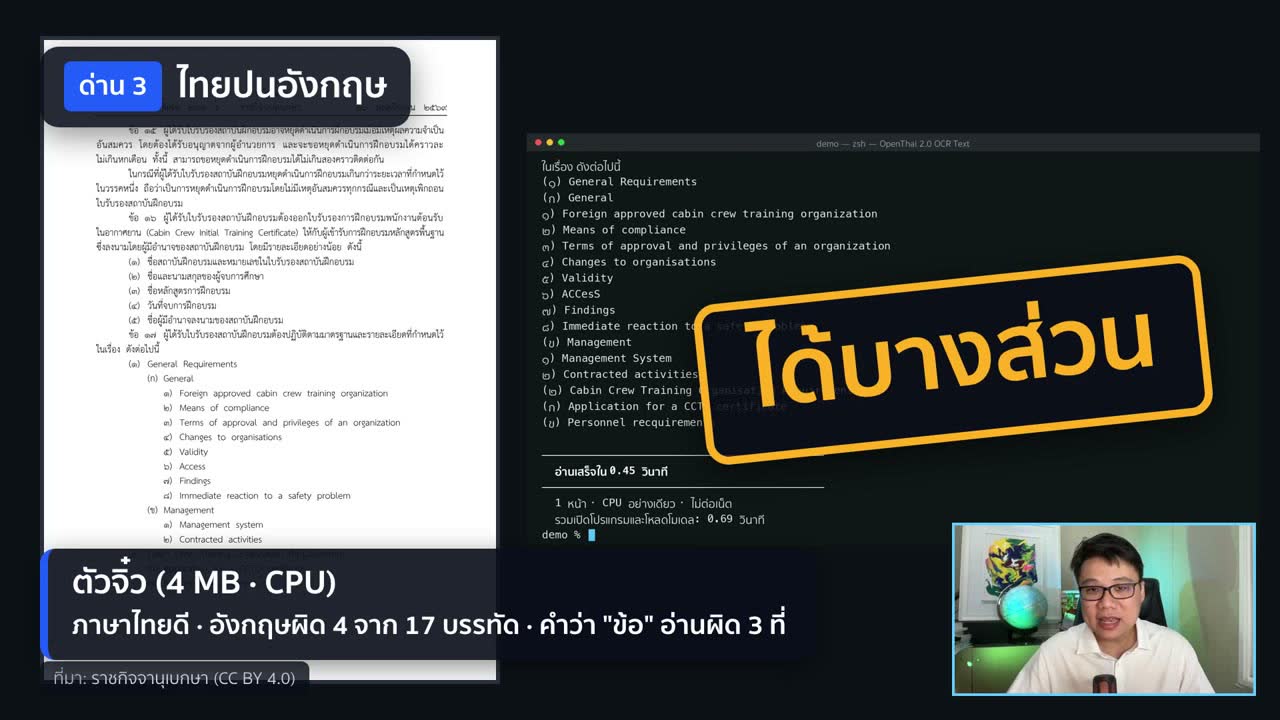
| 3 | ไทยปนอังกฤษ | 🟡 ได้บางส่วน: ภาษาไทยดี แต่อังกฤษผิด 4 จาก 17 บรรทัด |
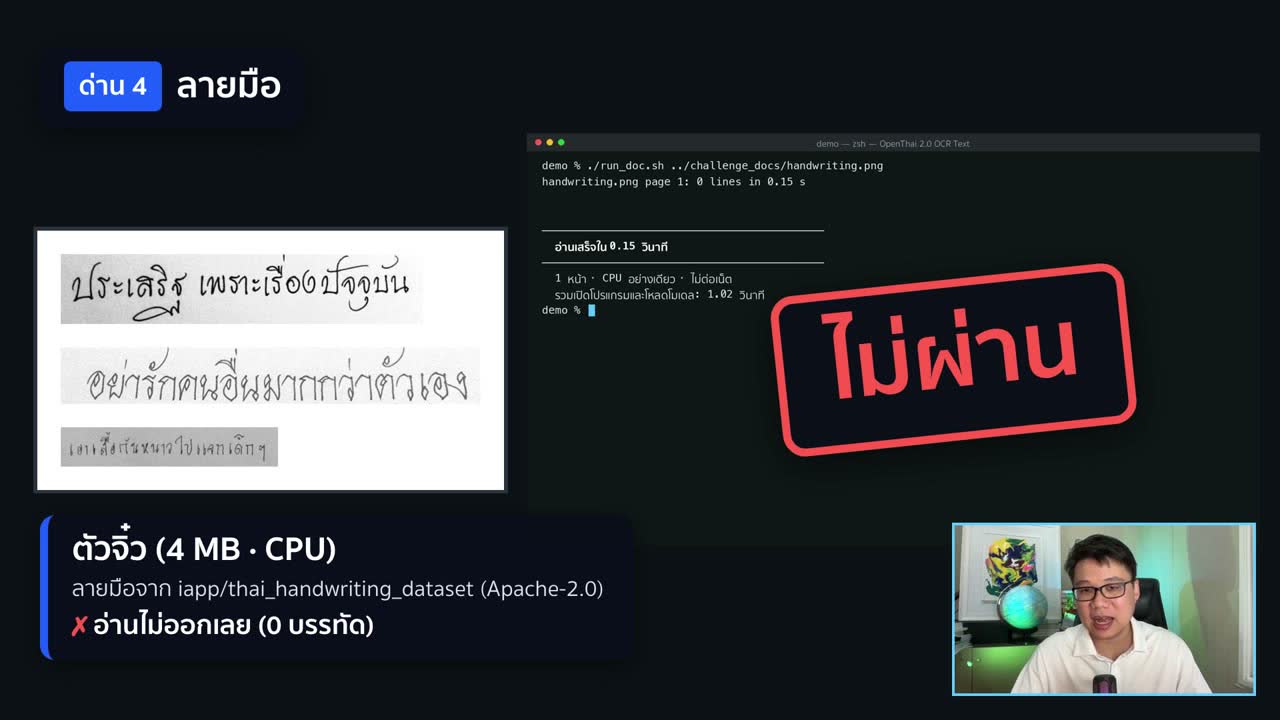
| 4 | ลายมือ | ❌ ไม่ผ่าน: ตัวจิ๋วอ่านได้แค่ตัวพิมพ์ |
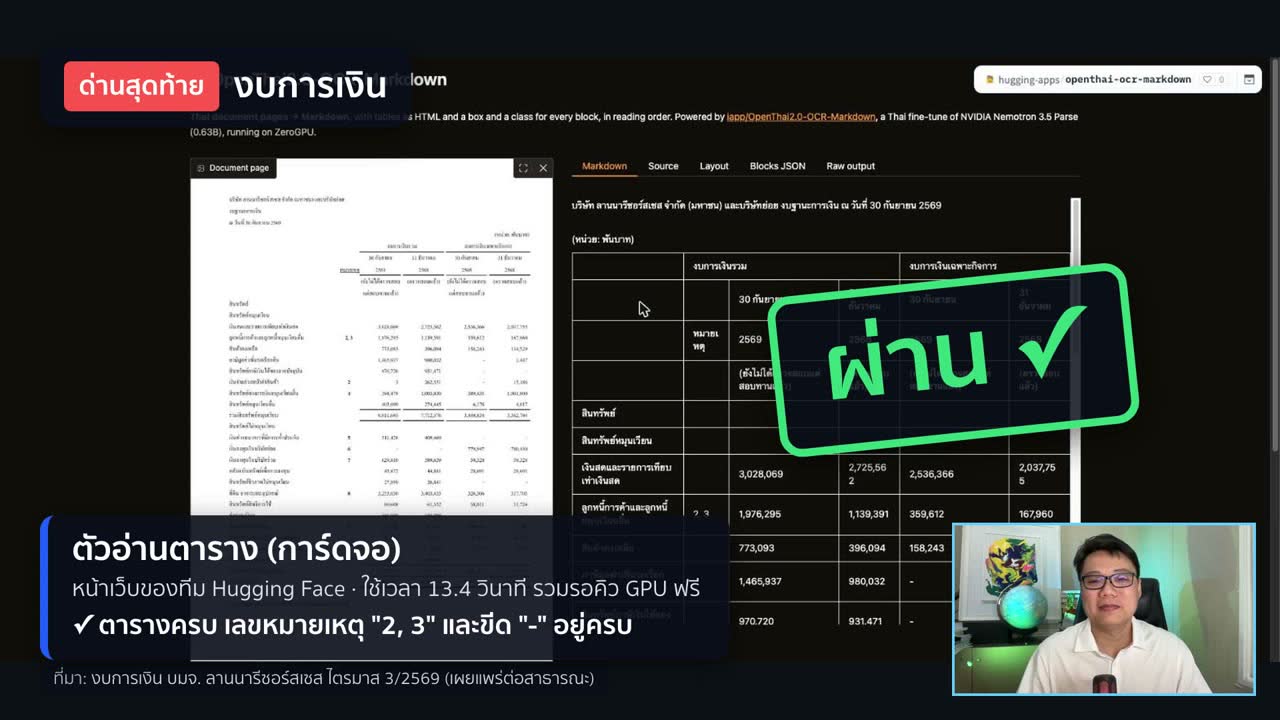
| 5 | งบการเงินบริษัทในตลาดหุ้น | ✅ ผ่าน: ตัวอ่านตารางได้ตารางครบ เลขหมายเหตุและขีดอยู่ครบ |
ด่าน 1 เลขไทยกับ ฎ ฏ ฐ มีคนถามว่า AI ต่างประเทศอ่านผิดหมด ตัวนี้จะรอดไหม ผลคือรอดครับ
ด่าน 2 หนังสือเก่าที่สแกนมา กฎหมายตั้งแต่ปี 2457 ตัวจิ๋วไม่ผ่าน บรรทัดแรกหายทั้งบรรทัด แต่พอให้ตัวอ่านตารางลองบนหน้าเว็บของทีม Hugging Face (16.1 วินาที รวมรอคิว GPU ฟรี) อ่านได้เกือบครบทั้งหน้า
ด่าน 3 ไทยปนอังกฤษ ตรงนี้ยังเป็นจุดอ่อนของเรา ภาษาไทยดี แต่ภาษาอังกฤษผิด 4 จาก 17 บรรทัด และคำว่า "ข้อ" อ่านผิด 3 ที่
ด่าน 4 ลายมือ อันนี้แพ้ครับ ตัวจิ๋วอ่านได้แค่ตัวพิมพ์ ส่วนลายมือหมอ อย่างที่มีคนตอบในคอมเมนต์ คนเราเองยังอ่านลำบาก
ด่านสุดท้าย งบการเงิน ตารางเยอะมาก ตัวอ่านตารางใช้ 13.4 วินาที (รวมรอคิว GPU ฟรี) ตารางครบ เลขหมายเหตุ "2, 3" และขีด "-" อยู่ครบ
รอบหน้า ทีมจะเทรนเพิ่มให้อ่านข้อความในรูปถ่าย การ์ตูน และภาษาอังกฤษได้เก่งขึ้น
ลิงก์ที่ใช้ในคลิป
- OpenThai 2.0 OCR Text ตัวจิ๋ว ใช้ CPU
- OpenThai 2.0 OCR Markdown ตัวอ่านตาราง ใช้การ์ดจอ
- คู่มือติดตั้ง Windows / Mac / Linux
- ใช้ผ่านบริการของ iApp
- หน้าเว็บทดลองโดยทีม Hugging Face
- ส่งผลงานจาก OpenThai มาโชว์
ใครมีเอกสารภาษาไทยที่ยากกว่านี้ (ไม่มีข้อมูลส่วนตัว) ส่งมาในคอมเมนต์ใต้คลิปได้เลย รอบหน้าผมเอามาลองให้ดูครับ
ไทม์ไลน์ในคลิป
- 0:00 AI 4 MB อ่านเอกสารไทย ไม่ต่อเน็ต
- 0:25 โพสต์เดียว 4 แสนวิว
- 1:50 ทำไม OCR ภาษาไทยยาก
- 2:24 ตัวจิ๋ว กับ ตัวอ่านตาราง
- 3:58 อ่าน 1,000 หน้าบนโน้ตบุ๊ก
- 4:27 สองตัวนี้มาจากไหน
- 5:01 คนเอาไปลองบนเครื่องตัวเอง
- 6:47 โรงเรียนในสะเดาทำเว็บ OCR เอง
- 7:18 นักพัฒนาเอาไปต่อยอด
- 8:35 ตัวถอดเสียง OpenThai
- 9:58 ทำไมโพสต์นี้ไปไกล
- 11:29 อยากลองเอง 3 ทาง
- 12:44 ด่านท้าทายจากคอมเมนต์
ที่มาของเอกสารในคลิป: ราชกิจจานุเบกษา ผ่าน open-law-data-thailand (CC BY 4.0) · สำนักงบประมาณ งบประมาณโดยสังเขป ปีงบประมาณ 2569 · วิกิซอร์ซ กฎหมาย ร.6 พ.ศ. 2457 · งบการเงิน บมจ. ลานนารีซอร์สเซส ไตรมาส 3/2569 (เผยแพร่ต่อสาธารณะ) · ลายมือจาก iapp/thai_handwriting_dataset (Apache-2.0)