DGX Spark เครื่องเดียว ให้คนถาม AI กฎหมายพร้อมกันได้กี่คน? ทดสอบโหลดจริง (Kobkrit.com EP.3)
ถ้าออฟฟิศมี NVIDIA DGX Spark หนึ่งเครื่อง แล้วให้ทุกคนถาม AI กฎหมายพร้อมกัน เครื่องจะรับได้กี่คนก่อนจะช้าจนใช้ไม่ได้? ใน EP.3 ผมแกะกล่อง ลง OpenThai 2.0 Legal พร้อมระบบค้นตัวบทกฎหมาย 2,065 ฉบับ ไว้ในเครื่องนี้ทั้งหมด แล้วทดสอบตั้งแต่ 1 ถึง 20 คนพร้อมกัน คำตอบสั้นๆ คือ 5 คน ถ้าทุกคนกดส่งพร้อมกันเป๊ะ และ ราว 2,000 คำถามต่อชั่วโมง ถ้าคำถามทยอยเข้ามาแบบออฟฟิศจริง
บทความนี้สรุปจาก Kobkrit.com EP.3 (ปล่อย 24 ต.ค. 2569) พร้อมตัวเลขทุกตัวที่วัดได้ เครื่อง DGX Spark ได้รับจาก NVIDIA เพื่อทดสอบ แต่ตัวเลขทุกตัวผมวัดเองด้วยสคริปต์เดียวกันทุกรอบ
แกะกล่อง: กล่องเล็กขนาดฝ่ามือ แต่หน่วยความจำ 128 GB
DGX Spark ตัวเครื่องขนาดประมาณ 15 × 15 เซนติเมตร เครื่องที่ผมได้เป็นรุ่น SSD 4TB หน่วยความจำ 128 GB ในกล่องมีตัวเครื่อง อะแดปเตอร์ไฟ และการ์ดคู่มือเริ่มต้น ด้านหลังมีช่อง USB-C ช่อง LAN ช่อง HDMI และช่อง ConnectX-7 ความเร็ว 200 กิกะบิต เอาไว้ต่อ DGX Spark สองเครื่องเข้าด้วยกัน
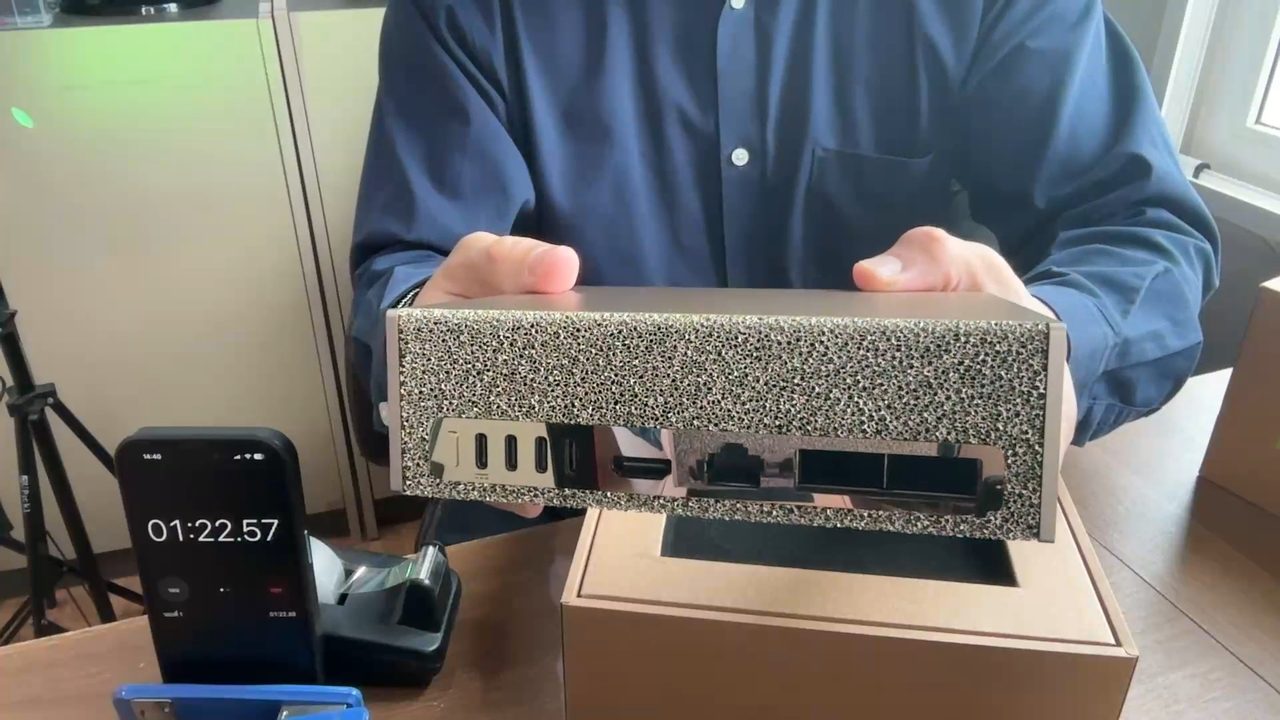
ราคาในไทยของ Leadtek DGX Spark รุ่น 4TB / 128GB อยู่ที่ราว 182,900–199,990 บาท (JIB และ Advice เช็กเมื่อ 23 ต.ค. 2569)
ตั้งเครื่อง 23 นาที แต่โหลดโมเดลชั่วโมงกว่า
ตั้งค่าครั้งแรกตั้งแต่เปิดเครื่องจนสร้างบัญชีเสร็จใช้เวลา 23 นาที ส่วนที่นานที่สุดคือโหลดโมเดลขนาด 63 GB ใช้ไป 1 ชั่วโมง 24 นาที เพราะสายแลนตรงจุดที่วางเครื่องวิ่งได้แค่ 100 เมกะบิต ถ้าเน็ตเร็วกว่านี้ ส่วนนี้จะสั้นลงมาก
ของที่ลงไว้ในเครื่องมี 3 ส่วน ทั้งหมดรันในกล่องนี้:
- โมเดล OpenThai 2.0 Legal รันด้วย vLLM ใน container ของ NVIDIA
- ระบบค้นตัวบทกฎหมาย ตัวบท 2,065 ฉบับ 54,217 มาตรา ค้นแบบผสม (คำค้น + ความหมาย) แล้วจัดอันดับใหม่ด้วย Qwen3 Embedding และ Reranker ขนาด 0.6B ชุดเดียวกับที่ใช้ในระบบจริงของเรา
- หน้าแชท สำหรับถามตอบ ที่แสดงมาตราที่อ้างและความเร็วของแต่ละคำตอบ
ตั้งเกณฑ์ก่อนวัด จะได้ไม่โกงตัวเอง
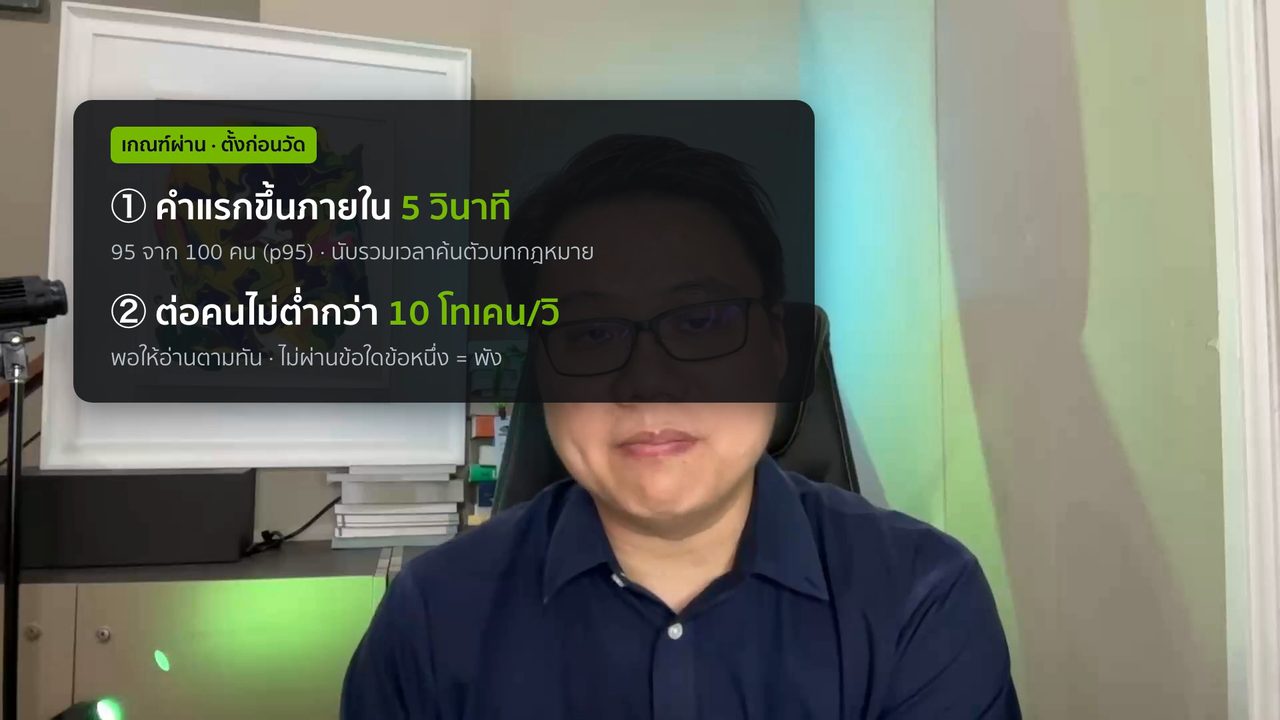
ก่อนเริ่ม ผมตั้งเกณฑ์ไว้สองข้อ ขั้นไหนไม่ผ่านข้อใดข้อหนึ่ง ถือว่าพัง:
- คำแรกต้องขึ้นภายใน 5 วินาที สำหรับ 95 จาก 100 คน (p95) นับรวมเวลาที่ระบบค้นตัวบทด้วย
- ข้อความต้องไหลไม่ช้ากว่า 10 โทเคนต่อวินาทีต่อคน ประมาณว่ายังอ่านตามทัน
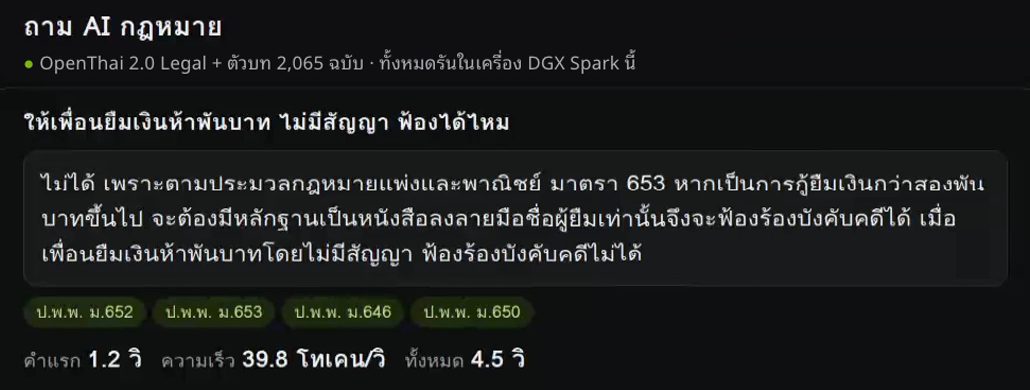
ถามจริง: ยืมเงินไม่มีสัญญา ฟ้องได้ไหม
คำถามแรกที่ผมพิมพ์คือ "ให้เพื่อนยืมเงินห้าพันบาท ไม่มีสัญญา ฟ้องได้ไหม" AI ค้นตัวบทในเครื่องก่อน แล้วตอบว่าฟ้องไม่ได้ เพราะตามประมวลกฎหมายแพ่งและพาณิชย์ มาตรา 653 การกู้ยืมเงินเกิน 2,000 บาทต้องมีหลักฐานเป็นหนังสือลงลายมือชื่อผู้ยืม จึงจะฟ้องร้องบังคับคดีได้ คำแรกขึ้นใน 1.2 วินาที ตอบเสร็จทั้งหมดใน 4.5 วินาที
คำถามที่สอง: AI ตอบผิด และผมเก็บไว้ในคลิป
ผมถามต่อว่า "ทำงานมาสามปี ถูกเลิกจ้างโดยไม่บอกล่วงหน้า มีสิทธิได้ค่าชดเชยเท่าไร" AI ตอบว่า 90 วัน ตามพ.ร.บ.คุ้มครองแรงงาน มาตรา 118 (๒) ซึ่งผิด ทำงานครบ 3 ปีพอดี ต้องได้ 180 วัน ตามมาตรา 118 (๓) (ครบ 3 ปีแต่ไม่ครบ 6 ปี)
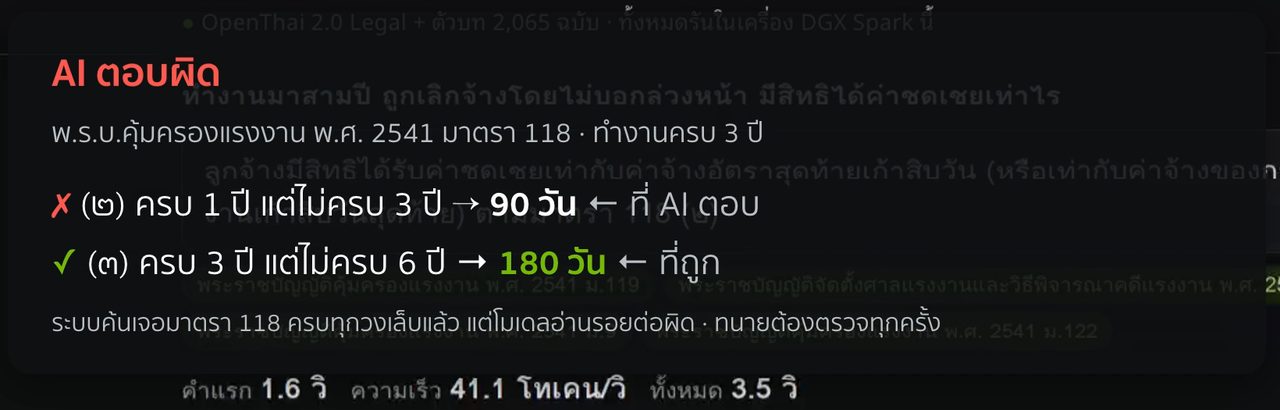
ระบบค้นเจอมาตรา 118 ที่มีครบทุกวงเล็บแล้ว แต่โมเดลอ่านเกณฑ์ตรงรอยต่อพลาด ผมไม่ตัดส่วนนี้ออก เพราะนี่คือเหตุผลที่ต้องย้ำว่า AI กฎหมายเป็นเครื่องมือช่วยตัดสินใจ ไม่ใช่คำปรึกษากฎหมาย ทนายต้องตรวจทุกการอ้างอิง
ทดสอบโหลด: 1 → 5 → 10 → 20 คนพร้อมกัน
ทีมผมมีไม่ถึงยี่สิบคน เลยใช้สคริปต์จำลองผู้ใช้ ยิงคำถามกฎหมายจริง 16 แบบจาก Mac ผ่านวงแลน ทุกคำถามผ่านระบบค้นตัวบทเต็มชุด เหมือนคนถามจริงทุกอย่าง ผลจากรอบที่อัดในคลิป:
| คนถามพร้อมกัน | คำแรก (p95) | ความเร็วต่อคน | ทั้งเครื่องรวม | ผล |
|---|---|---|---|---|
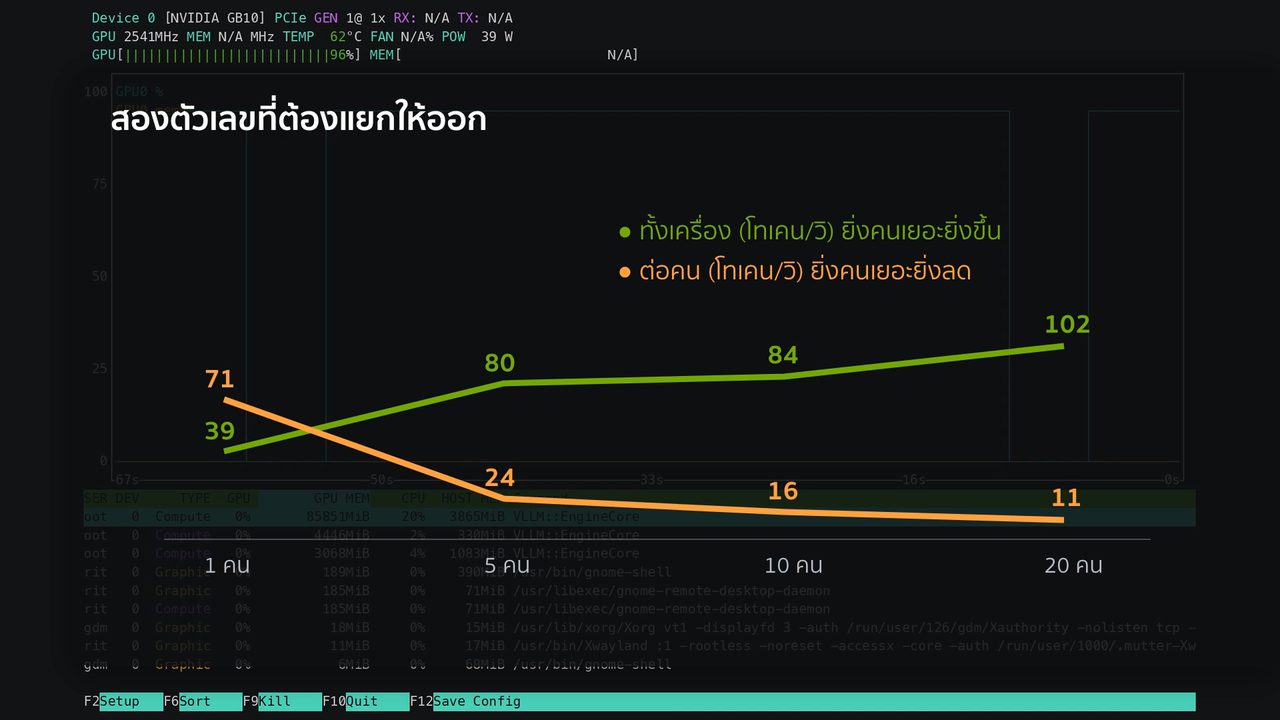
| 1 คน | 1.0 วิ | 71 โทเคน/วิ | 39 โทเคน/วิ | ผ่าน |
| 5 คน | 4.1 วิ | 24 โทเคน/วิ | 80 โทเคน/วิ | ผ่าน |
| 10 คน | 9.0 วิ | 16 โทเคน/วิ | 84 โทเคน/วิ | ไม่ผ่าน (คำแรกเกิน 5 วิ) |
| 20 คน | 15.0 วิ | 11 โทเคน/วิ | 102 โทเคน/วิ | ไม่ผ่าน |
ห้าคนพร้อมกัน เท่ากับออฟฟิศทนายเล็กๆ หนึ่งแห่ง คนที่ช้าที่สุดได้คำแรกใน 4 วินาที ยังผ่านเกณฑ์
ทำไมสิบคนถึงพัง
ทุกคำถาม ระบบจะแนบตัวบทกฎหมายที่ค้นเจอไปให้โมเดลอ่านด้วย ราว 2,400 โทเคน สิบคนพร้อมกันก็ราว 24,000 โทเคน แต่เครื่องนี้อ่านได้ราว 8,000 โทเคนต่อวินาที คนท้ายคิวเลยต้องรอเกือบ 9 วินาทีกว่าคำแรกจะขึ้น
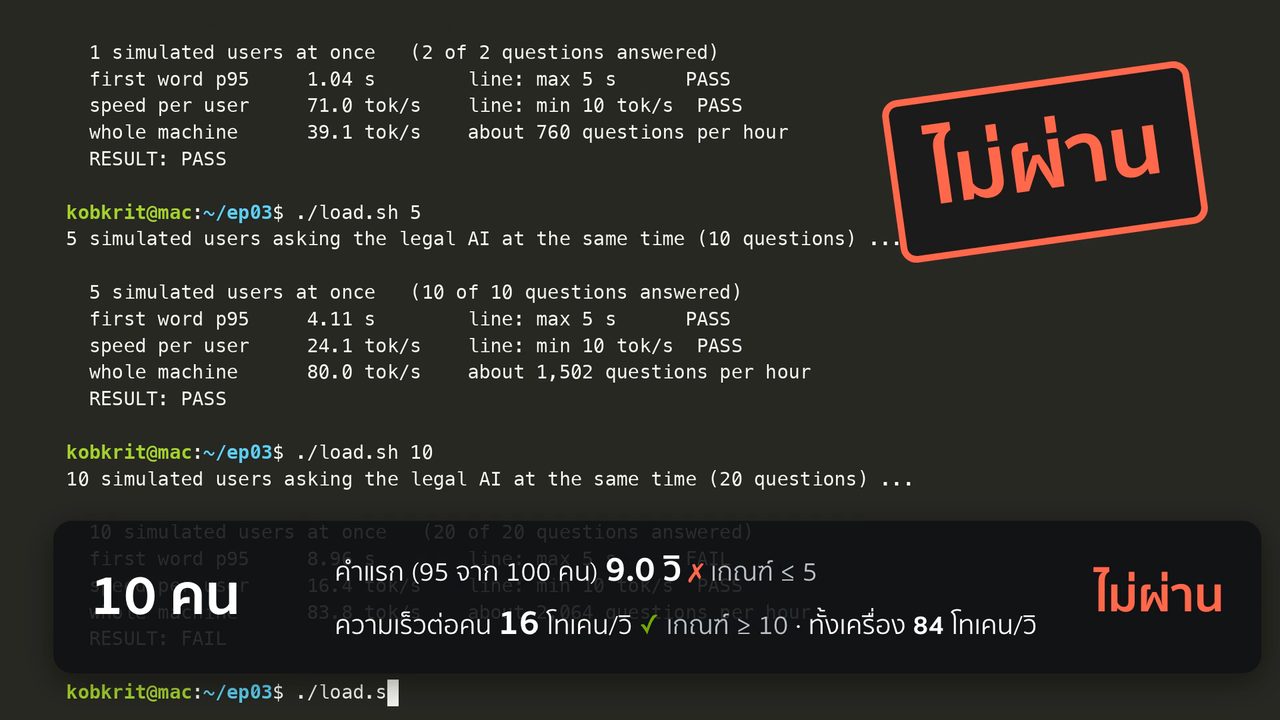
ที่น่าสนใจคือ พอเริ่มตอบแล้ว แต่ละคนยังได้ 16 โทเคนต่อวินาที อ่านตามทันสบาย คอขวดจึงอยู่ที่ช่วง "อ่านตัวบท" ก่อนตอบ ไม่ใช่ช่วงตอบ
สองตัวเลขที่ต้องแยกให้ออก
- ความเร็วรวมทั้งเครื่อง ยิ่งคนเยอะยิ่งขึ้น จาก 39 เป็น 102 โทเคนต่อวินาที
- ความเร็วที่แต่ละคนรู้สึก ยิ่งคนเยอะยิ่งลด จาก 71 เหลือ 11 โทเคนต่อวินาที
เวลาอ่านผลทดสอบ AI ของใคร ให้ดูว่าเขาพูดถึงตัวไหน เกณฑ์ของผมดูเวลารอคำแรกกับตัวที่สอง เพราะคนใช้ไม่สนว่าเครื่องเร็วรวมเท่าไร สนแค่ว่าของตัวเองช้าไหม
ทำไมต้องใช้แบบบีบอัด 4 บิต
ตอนซ้อม ผมลองโมเดลแบบเต็ม 16 บิต (BF16) ก่อน แค่ 5 คนก็พังแล้ว คำแรก p95 7.18 วินาที ต่อคนราว 13 โทเคนต่อวินาที เพราะพอหลายคนถามพร้อมกัน ผู้เชี่ยวชาญย่อยในโมเดลถูกเรียกใช้หลายตัวขึ้น เครื่องต้องอ่านน้ำหนักเกือบทั้งโมเดลทุกคำ และหน่วยความจำของ DGX Spark อ่านได้ 273 GB ต่อวินาที เลยตัน
คลิปนี้จึงใช้ แบบบีบอัด 4 บิต (NVFP4) น้ำหนักแต่ละตัวเหลือ 4 บิตจาก 16 บิต ไฟล์โมเดลเล็กลงจาก 63 GB เหลือ 20 GB
ซ้อมรอบเดียวกัน 5 คน ความเร็วต่อคนขึ้นจาก 13 เป็น 25 โทเคนต่อวินาที แต่คำแรกยังช้าไปนิด (5.35 วินาที)
พอปรับค่า --max-num-batched-tokens ของ vLLM จาก 2048 เป็น 8192 ให้เครื่องอ่านตัวบทของหลายคนได้ในรอบเดียว
คำแรกก็ลดเหลือ 4.1 วินาที ห้าคนพร้อมกันจึงผ่านเกณฑ์ ต้องใช้ทั้งสองอย่าง
สรุป: รับได้กี่คน
- ถ้าทุกคนกดส่งพร้อมกันเป๊ะ เครื่องนี้ผ่านเกณฑ์ได้ 5 คน
- ถ้าคำถามทยอยเข้ามา เครื่องนี้ตอบได้ ราว 2,000 คำถามต่อชั่วโมง
ในออฟฟิศจริงคนไม่ได้กดพร้อมกันทุกวินาที ออฟฟิศ 50 คน ถามคนละ 5 ข้อต่อชั่วโมง รวม 250 ข้อ ยังใช้ไม่ถึง 1 ใน 8 ของที่เครื่องนี้ตอบไหว ตราบใดที่ไม่กดส่งพร้อมกันเกินห้าคน
ทำไมต้องรัน AI เองในออฟฟิศ
ทั้งที่ใช้ AI บนคลาวด์อย่าง ChatGPT, Claude หรือ Gemini ก็ได้ ทำไมต้องรันเอง? เพราะสำนักงานกฎหมาย โรงพยาบาล หน่วยงานรัฐ และหน่วยงานความมั่นคงหลายแห่ง ไม่อยากให้ข้อมูลลูกความ ข้อมูลคนไข้ หรือข้อมูลลับออกนอกองค์กร
พอรันใน DGX Spark คำถามทุกข้อ คำตอบทุกข้อ และเอกสารที่ใช้อ้างอิงทั้งหมด อยู่ในกล่องนี้ ในห้องนี้เท่านั้น และไม่มีค่าบริการต่อคำถาม เหลือแค่ค่าเครื่องกับค่าไฟ
OpenThai 2.0 Legal เทรนมายังไง
OpenThai 2.0 Legal เป็นโมเดลกฎหมายไทยที่ทีม iApp เปิดให้ดาวน์โหลดบน Hugging Face ตั้งแต่ 24 กรกฎาคม 2569 เราเริ่มจาก NVIDIA Nemotron 3 Nano แล้วสอนต่ออีก 3 ขั้นด้วย NVIDIA NeMo (ต้องขอบคุณทีม NVIDIA ที่บินมาสอนทีม iApp ถึงที่):
- อ่านกฎหมายไทย (Continued Pretraining) รวบรวมหนังสือกฎหมายไทยจำนวนมาก สแกนแล้วทำ OCR เป็นข้อความให้โมเดลอ่าน จนโมเดลรู้จักแนวคิดเฉพาะทาง เช่น คดีอุทลุม ที่ลูกฟ้องบุพการีของตัวเองไม่ได้
- สอนตอบคำถาม (Fine-tuning) ใช้ข้อสอบกฎหมายที่มีสถานการณ์และคำตอบ ตัวอย่างการเขียนสัญญา คำถามคำตอบด้านกฎหมาย และการวิเคราะห์คำพิพากษา โดยมีผู้เชี่ยวชาญด้านกฎหมายช่วยเตรียมข้อมูล
- ให้คะแนนแล้วสอนซ้ำ (Reinforcement Learning) ให้โมเดลตอบคำถามที่มนุษย์ตรวจไว้แล้ว ให้คะแนนเมื่ออ้างมาตราถูก หักคะแนนเมื่ออ้างผิดหรือขาด แล้วสอนซ้ำในจุดที่ตอบผิด โดยไม่ลืมส่วนที่ตอบถูกอยู่แล้ว
ที่มันตอบเร็วบนกล่องเล็กๆ ได้ เพราะเป็นโมเดลแบบ Mixture of Experts (MoE) ขนาดรวม 30,000 ล้านพารามิเตอร์ ข้างในแต่ละชั้นมีผู้เชี่ยวชาญย่อย 128 ตัว แต่ทุกคำที่ตอบ ระบบเลือกใช้แค่ 6 ตัว รวมแล้วใช้จริงราว 3,000 ล้านพารามิเตอร์ต่อคำ คำนวณน้อยกว่าโมเดลขนาดเท่ากันแบบปกติราว 10 เท่า
รายละเอียดเพิ่มเติมของโมเดล อ่านได้ในบทความเปิดตัว OpenThai 2.0 Legal
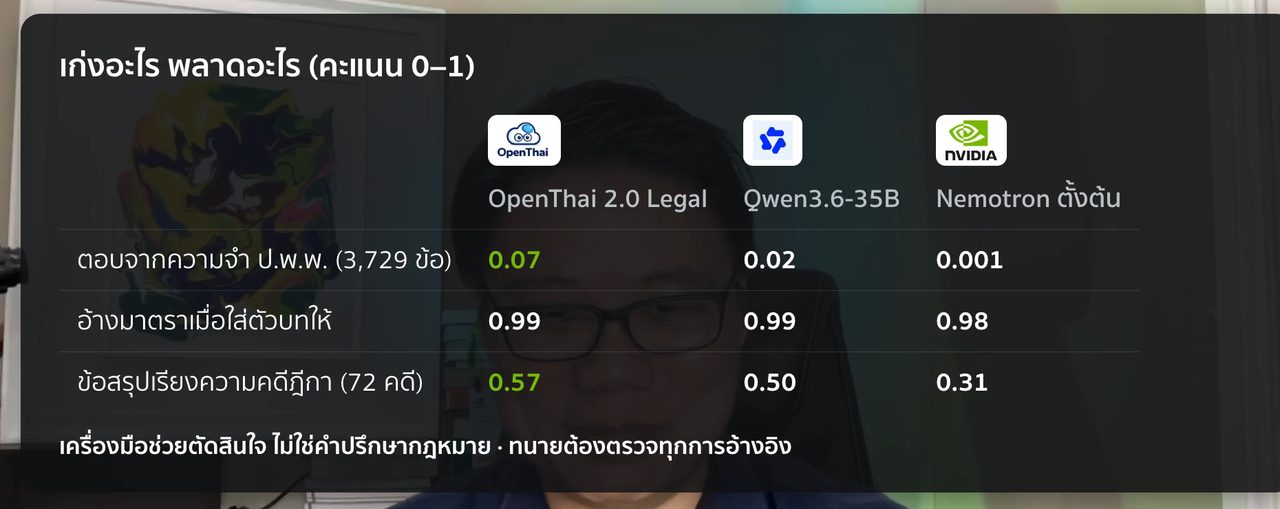
เก่งอะไร พลาดอะไร (คะแนนจริง)
| ข้อสอบ (คะแนน 0–1) | OpenThai 2.0 Legal | Qwen3.6-35B | Nemotron ตั้งต้น |
|---|---|---|---|
| ตอบจากความจำ ป.พ.พ. ไม่ให้ตัวบท (3,729 ข้อ) | 0.07 | 0.02 | 0.001 |
| อ้างมาตราเมื่อใส่ตัวบทให้ | 0.99 | 0.99 | 0.98 |
| ข้อสรุปเรียงความคดีฎีกา (72 คดี) | 0.57 | 0.50 | 0.31 |
ผมบอกตรงๆ:
- ตอบจากความจำล้วนๆ ชนะก็จริง แต่ 0.07 ยังต่ำมาก อย่าใช้แบบไม่ให้ตัวบท ในคลิปนี้ทุกคำถามระบบจะค้นตัวบทให้ก่อนตอบ
- เมื่อใส่ตัวบทให้ อ้างมาตราถูก 0.99 แต่ Qwen ก็ได้เท่ากัน ตรงนี้เราไม่ได้ชนะใคร
- ข้อสอบเรียงความจากคดีศาลฎีกา ได้ข้อสรุปถูก 0.57 Qwen ได้ 0.50
รุ่น 64GB พอไหม
DGX Spark รุ่นหน่วยความจำ 64 GB เพิ่งวางขายเมื่อ 23 ต.ค. 2569 ราคาตั้ง 4,999 ดอลลาร์ คำถามคือพอไหม
- แบบเต็ม (BF16) โมเดลใช้หน่วยความจำ 58.93 GiB หรือราว 63 GB เกือบเต็มเครื่อง 64 GB ทั้งเครื่อง ยังไม่นับระบบปฏิบัติการ และหน่วยความจำที่ต้องใช้ตอนหลายคนถามพร้อมกัน แบบเต็มจึงแทบไม่พอ
- แบบบีบอัด 4 บิต (NVFP4) ใช้ 18.92 GiB หรือราว 20 GB เหลือที่อีกเยอะ
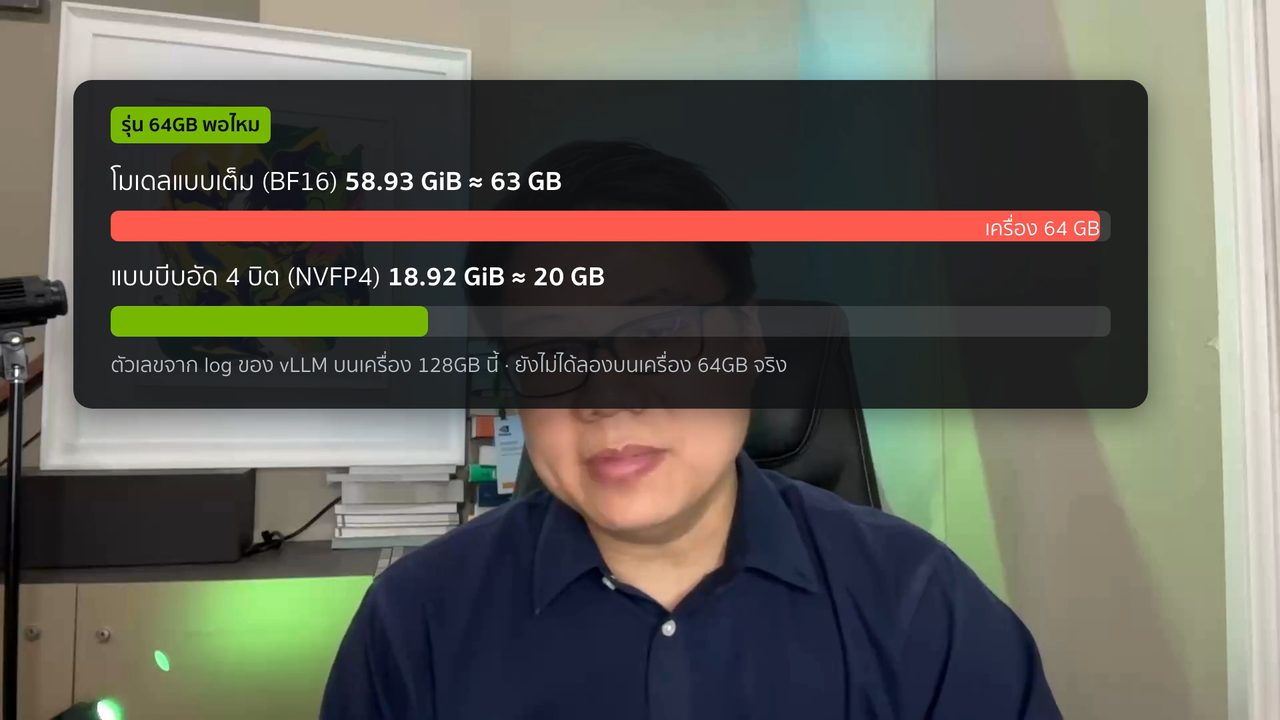
ตัวเลขนี้มาจาก log ของ vLLM บนเครื่อง 128 GB ผมยังไม่ได้ลองบนเครื่อง 64 GB จริง เลยยังไม่ฟันธง
สำหรับคนที่อยากลองทำตาม
- เครื่อง DGX Spark (GB10) บน DGX OS (Ubuntu 24.04 แบบ ARM) พร้อม Docker และ NVIDIA Container Toolkit มาในเครื่องแล้ว
- ตัวรันโมเดล vLLM ใน container
nvcr.io/nvidia/vllm:26.09-py3ตั้ง--max-num-batched-tokens 8192ค่าเริ่มต้นบนเครื่องนี้ (2048) ทำให้คำถามที่มาพร้อมกันต่อคิวนานกว่าคำแรกจะขึ้น ในเวอร์ชันนี้ vLLM รัน NVFP4 ด้วย kernel Marlin (แตก 4 บิตกลับเป็น BF16 ตอนคำนวณ) ยังไม่ใช่ FP4 แบบเนทีฟ - แบ่งหน่วยความจำ ตั้ง
--gpu-memory-utilization 0.70เพื่อเหลือที่ให้โมเดลค้นตัวบท และเปิด vLLM ทีละตัว เปิดพร้อมกันหลายตัวแล้วการกันหน่วยความจำจะพัง - ระหว่างทดสอบ ปิดโหมดคิด (thinking) ทุกคำถาม และวัดจาก Mac ผ่านวงแลน
ดาวน์โหลดโมเดลได้ที่ Hugging Face (NVIDIA Open Model License):
ถ้าออฟฟิศของคุณมี DGX Spark หนึ่งเครื่อง อยากให้ AI ช่วยงานอะไรก่อนครับ? คอมเมนต์ไว้ใต้คลิปได้เลย เดี๋ยวผมเลือกไปลองให้ดูในไลฟ์วันพฤหัส
ไทม์ไลน์ในคลิป
- 0:00 AI กฎหมายในกล่องเดียว พังที่กี่คน?
- 0:11 แกะกล่อง DGX Spark
- 1:53 วันนี้จะทดสอบอะไร
- 2:29 ตั้งเครื่อง + โหลดโมเดล 63 GB
- 2:56 เกณฑ์ผ่าน: คำแรก 5 วิ · 10 โทเคน/วิ
- 3:36 ถาม AI: ยืมเงินไม่มีสัญญา ฟ้องได้ไหม
- 5:16 คำถามที่ 2: AI ตอบผิดตรงไหน
- 6:15 ทดสอบ 1 คน และ 5 คนพร้อมกัน
- 7:18 ทำไมต้องรัน AI เอง
- 8:20 OpenThai 2.0 Legal เทรนมายังไง
- 11:37 ผู้เชี่ยวชาญย่อย 128 ตัว ใช้แค่ 6
- 12:01 เก่งอะไร พลาดอะไร (คะแนนจริง)
- 14:24 รุ่น 64 GB พอไหม
- 15:34 10 คน และ 20 คน: พังตรงไหน
- 16:23 สองตัวเลขที่ต้องแยกให้ออก
- 17:17 สรุป: รับได้กี่คน
AI กฎหมายเป็นเครื่องมือช่วยตัดสินใจ ไม่ใช่คำปรึกษากฎหมาย ทนายต้องตรวจทุกการอ้างอิง · เครื่อง DGX Spark ได้รับจาก NVIDIA เพื่อทดสอบ ตัวเลขทุกตัวผมวัดเอง