ข้ามไปยังเนื้อหาหลัก

35 บทความ ที่ติดแท็ก "ai"

ดูแท็กทั้งหมด

[LLM 4/10] DPO: เมื่อโมเดลภาษากลายเป็น reward model ของตัวเอง

· อ่าน 7 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่แล้วเราทำ RLHF ด้วย PPO และคุณคงเห็นแล้วว่ามันมีชิ้นส่วนเยอะแค่ไหน — ต้องเทรน reward model แยกหนึ่งตัว ต้องโหลดโมเดลพร้อมกัน 4 ตัวใน VRAM ต้องจูน PPO อีกสิบกว่าพารามิเตอร์ และถ้า reward model เพี้ยน โมเดลจะไปเจอทางลัดที่โกงคะแนนได้ บทนี้เราจะทำสิ่งเดียวกันด้วยลูป training ธรรมดาแบบ supervised — ไม่มี reward model ไม่มี RL และที่สำคัญคือ มันไม่ใช่การประมาณ เราจะพิสูจน์ด้วยพีชคณิตว่าทั้งสองชิ้นนั้นตัดกันหายไปจริง ๆ

[LLM 5/10] GRPO: ลบ value network ทิ้ง แล้วให้กลุ่มคำตอบเป็น baseline ของกันเอง

· อ่าน 9 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่แล้วเราปิดท้ายด้วยช่องว่างของ DPO: มันจัดอันดับได้เฉพาะคำตอบที่มีคนเตรียมไว้ในไฟล์ ส่วนบทที่ 3 เราจ่ายราคาเต็มของ PPO: โมเดล 4 ตัวใน VRAM และ value network ทั้งตัวที่ต้องเทรนเพิ่ม บทนี้เราจะเอาข้อดีของทั้งสองมารวมกัน — ให้โมเดลสุ่มคำตอบของตัวเองมาเรียนแบบ RL จริง ๆ แต่ลบ value network ทิ้งทั้งก้อน ด้วยข้อสังเกตทางสถิติที่เรียบง่ายจนน่าหงุดหงิดว่าทำไมไม่มีใครคิดก่อน: ถ้าสุ่มคำตอบหลายอันต่อโจทย์เดียวกัน ค่าเฉลี่ย reward ของกลุ่มก็คือ baseline ที่ value network พยายามประมาณอยู่แล้ว และถ้าโจทย์ตรวจคำตอบได้ด้วยโค้ด เราไม่ต้องใช้ข้อมูล preference จากมนุษย์เลย — ศูนย์คู่ ศูนย์บาท

[LLM 6/10] Context Distillation: ย้าย system prompt เข้าไปเก็บในน้ำหนักโมเดล

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

ทุกครั้งที่ผู้ใช้ส่งข้อความหาแชตบอตของคุณ คุณแนบ system prompt ก้อนเดิมยาวหลายร้อย token ไปด้วยเสมอ — ทุก request ตลอดอายุของระบบ จ่ายซ้ำไม่มีวันจบ บทนี้เราจะย้ายความรู้ก้อนนั้นจาก prompt เข้าไปอยู่ในน้ำหนักโมเดลด้วยเทคนิคชื่อ Context Distillation ในเวอร์ชัน on-policy (OPCD) จุดที่สวยที่สุดคือ ครูกับนักเรียนเป็นโมเดลตัวเดียวกันเป๊ะ ๆ — สิ่งเดียวที่ต่างกันคือใครได้เห็น prompt

[LLM 7/10] Model Distillation: คำตอบที่ผิดของครู คือส่วนที่มีค่าที่สุด

· อ่าน 9 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่ 6 เรากลั่น "บริบท" เข้าไปในน้ำหนักของโมเดลตัวเดิม บทนี้เราจะกลั่น "โมเดลทั้งตัว" ลงไปในโมเดลที่เล็กกว่า สองบทนี้เป็นคู่กันโดยตั้งใจ: context distillation เปลี่ยนสิ่งที่โมเดลรู้โดยไม่ต้องบอกมันอีกต่อไป — model distillation เปลี่ยนขนาดของโมเดลโดยพยายามไม่เปลี่ยนสิ่งที่มันทำได้ และหัวใจของบทนี้ขัดสัญชาตญาณอย่างแรง: สิ่งที่มีค่าที่สุดที่ครูส่งให้นักเรียนได้ ไม่ใช่คำตอบที่ถูก แต่คือวิธีที่ครูผิด — และปุ่มที่ชื่อ temperature คือสิ่งที่ทำให้เรามองเห็นมัน

[LLM 8/10] Guardrails: รั้วนิรภัยที่แท้จริงไม่ใช่โมเดล แต่คือ threshold

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

แชตบอตภาษาไทยที่ผมและทีม deploy ให้ลูกค้าใช้งานจริง ไม่ได้เจอแต่คำถามสุภาพ ๆ — มีคนขอสูตรทำของผิดกฎหมาย มีคนพยายามหลอกให้มันด่าคนอื่น และมีวันที่โมเดลพ่นเบอร์โทรลูกค้าออกมาเอง บทนี้เราจะสร้างระบบป้องกันทั้งสองทิศ: classifier ตรวจ prompt อันตรายขาเข้า และ ตัวกรอง PII ขาออก แต่ประเด็นแกนกลางของบทไม่ใช่ตัวโมเดล — มันคือความจริงที่ว่า guardrail เป็นการตัดสินใจเรื่อง threshold ภายใต้ต้นทุนที่ไม่สมมาตร และตัวเลข "accuracy 94%" ที่คนชอบโชว์กันนั้น แทบไม่มีความหมายเลย

[LLM 9/10] Benchmarking: ตัวเลข accuracy ที่ไม่มี confidence interval คือข่าวลือ

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

ตั้งแต่บทที่ 1 ซีรีส์นี้พูดประโยคเดิมซ้ำทุกครั้งที่รายงานตัวเลข: "accuracy ที่ไม่มี confidence interval ไม่ใช่ผลการทดลอง มันคือข่าวลือ" และสัญญาไว้ว่าจะอธิบายเต็ม ๆ ในบทที่ 9 — บทนี้แหละครับ เราจะไม่เทรนอะไรเลยแม้แต่ step เดียว แต่จะสร้างระบบวัดผลสามโหมดขึ้นจากศูนย์ เอาทุก checkpoint ที่เทรนมาตลอดซีรีส์ขึ้นมาวัดบนข้อสอบไทยจริง แล้วพิสูจน์ว่า การตั้งค่าที่ไม่มีใครเขียนไว้ใน paper เปลี่ยนคะแนนของโมเดลตัวเดิมได้มากกว่าช่องว่างบน leaderboard ที่คนเถียงกัน

[LLM 10/10] Deployment: คุณไม่ได้รอการคำนวณ คุณรอน้ำหนักเดินทาง

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

เก้าบทที่ผ่านมาเราใส่ความรู้ สอนรูปแบบ จัด preference กลั่นโมเดล กันโมเดลพัง และวัดผลอย่างซื่อสัตย์ แต่โมเดลที่ดีที่สุดของเราก็ยังเป็นแค่ไฟล์ checkpoint ที่ไม่มีใครเรียกใช้ได้ บทสุดท้ายนี้เอามันขึ้นเสิร์ฟจริง และพิสูจน์ประโยคเดียวที่ควบคุมทุกการตัดสินใจของงานเสิร์ฟ LLM: การ decode ทีละ token ไม่ได้ถูกจำกัดด้วยพลังคำนวณ แต่ถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ — เราจะคำนวณเพดานความเร็วจาก datasheet ของ GPU ก่อนเขียนโค้ดแม้แต่บรรทัดเดียว แล้วค่อยวัดของจริงมาเทียบ

รวบรวม Link สำหรับเรียนรู้ Transformer สำหรับ SuperAIEngineer Season 3

· อ่าน 3 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

Schedule​

27 Feb 2023

13:00–13:05 แนะนำว่าโจทย์ QA คืออะไร และ Transformer เอาไปอะไรได้บ้าง
13:05–14:00 NLP Core Knowledge
14:00–14:05 — — Brain Break — —
14:05–15:00 Transformer Core Knowledge
15:00–15:05 — — Brain Break — —
15:05–16:00 Colab 1 (Preprocessing + Text Class) + Colab สร้าง QA
16:00–16:15 Q/A Session

— —

28 Feb 2023
09:00–10:00 Colab 2 (NE + POS+ WS + SS)
10:00–10:05 — — Brain Break — —
10:05–11:00 How ChatGPT Build and Works?
11:00–11:05 — — Brain Break — —
11:05–12:00 Colab: Making Your Own ChatGPT (As the way we did on OpenThaiGPT 0.0.1) + Colab: Reinforcement Learning with Human Feedback (RLHF)
12:00–12:15 Q/A Session + OpenThaiGPT Open for Volunteers.

โจทย์ QA​

อะไรคือ QA: https://ai.iapp.co.th/product/thai_automatic_qa
Colab สร้าง QA: https://colab.research.google.com/drive/1inDOJzCh-iG3_aAU-73tq3FzlCwM8nvY

NLP Core Knowledge​

Slide (Basic NLP -> Word Embbeding -> LSTM): https://drive.google.com/file/d/14AVefnJvgaNXWw6wo-kpmHQyjLAikMgp/view?usp=sharing

Transformer Core Knowledge​

Slide​

Slide (Thai NLP in Transformers Era): https://drive.google.com/file/d/1-V-Gy45c7vHQ4GejvWDBHk0w9oJ4z18I/view?usp=sharing

Colab​

Colab 1 (Preprocessing + Text Class): https://colab.research.google.com/drive/1fGKoS1WH6dbw3mYffOgTtdmPN2Wi9doF?usp=sharing
Colab 2 (NE + POS+ WS + SS): https://colab.research.google.com/drive/1CWamaQH1Lgd7mSZ0UZ4jx2AUMAGDpsfq?usp=sharing#scrollTo=cvrnEG4mOm1p

ChatGPT Core Knowledge​

Website​

https://openthaigpt.aieat.or.th/

Slide​

Slide (ChatGPT: How it works?): https://docs.google.com/presentation/d/1Q6_S_GDWHuNC0DfprNMn9EH0kyqK_y-RbdK5fJB6EUk/edit#slide=id.g1f3418062d6_0_156

Slide (OpenThaiGPT):
https://docs.google.com/presentation/d/1JJxtwo1pCJC3u6aSfslSp1FJSb5ZS5xBKIiQ-6Kip_g/edit?usp=sharing

Colab
Finetuning OpenThaiGPT version POC 0.0.1:
https://colab.research.google.com/drive/1MA1FHwknrs6mVstOHcSyFTnDNWrus-G-?usp=sharing

RLHF: สอนให้ Model Generate ข้อความเชิงบวก (Positive Sentiment) ได้มากขึ้นด้วย PPO https://colab.research.google.com/drive/1qce78Q00SY7CKXLVtiSGFbP5C1V_nypn?usp=sharing


รวบรวม Link สำหรับเรียนรู้ Transformer สำหรับ SuperAIEngineer Season 3 was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.

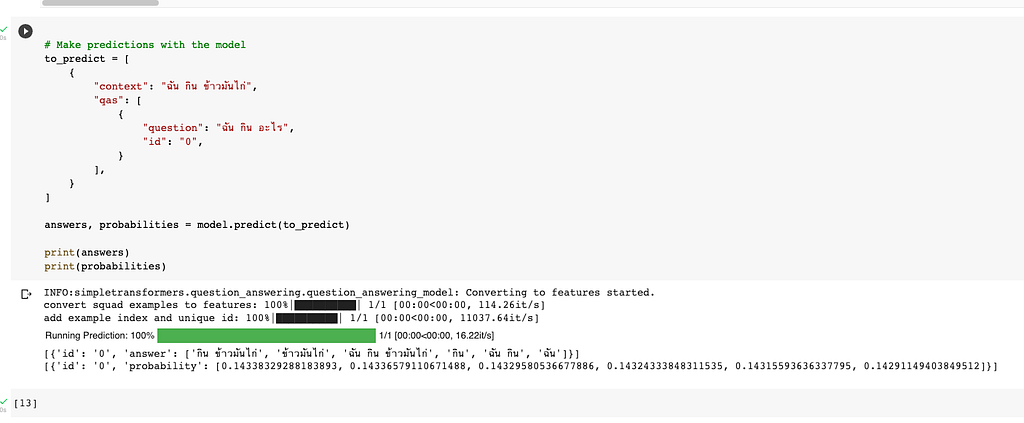
แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple Transformer

· อ่าน 2 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple Transformer​

How to make Thai QA System using SimpleTransformer

Colab:

https://colab.research.google.com/drive/1inDOJzCh-iG3_aAU-73tq3FzlCwM8nvY#scrollTo=vLChKnukd3gC


แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple… was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.

ศักยภาพของ AI สู่โอกาสใหม่แห่งการแข่งขันและความสำเร็จ

· อ่าน 7 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

https://medium.com/media/f8ead5836ef79253f028959f246dd628/href

สวัสดีครับ เจอกันอีกแล้วนะครับ ผม กอบกฤตย์ นะครับ

เนื่องจากทางผมมีโอกาสได้ไปพูดที่งาน Metalex 2019 เป็นครั้งที่สองแล้วนะครับ ในฐานะกรรมการสมาคมปัญญาประดิษฐ์ประเทศไทย (AIAT) ในหัวข้อเรื่อง ศักยภาพของ AI สู่โอกาสใหม่แห่งการแข่งขันและความสำเร็จ ซึ่งเป็นแนวที่ค่อนข้าง Abstract มาก ผมเลยคิดว่า มันก็เป็นโอกาสอันดีเหมือนกัน ที่ได้สรุปข่าว AI ที่สำคัญๆในปี 2019 มารวบรวมให้กับผู้อ่านทุกท่าน และให้ทุกท่านได้เตรียมตัวปรับตัวกับกระแส AI Disruption ที่จะรุนแรงขึ้นเรื่อยๆในปี 2020 นะครับ โดยหัวข้อที่ผมพูดแบ่งเป็น 3 หัวข้อหลักดังนี้นะครับ

หัวข้อที่ 1: เรื่องความก้าวหน้าด้าน AI ของทั้งโลกในปี 2019 ต้องยอมรับว่า สิ่งที่ก้าวหน้าที่สุดในปี 2019 นี่ ผมต้องยกให้กับเรื่อง Transfer Learning เลยครับ Transfer Learning คือการที่ AI เรียนรู้ข้อมูลจากแหล่งอื่นมาก่อน (มักจะเป็น Unsupervised Learning) แล้วสามารถนำมาสร้าง Model ใหม่ตามที่เราต้องการได้โดยใช้ข้อมูลน้อยลงมากๆ และ ไม่ว่าจะเป็น Domain ที่ชัดเจนมากๆ อาทิเช่น Natural Language Processing โดยการสร้าง Langauge Model จาก Corpus บทความขนาดใหญ่ ด้วยวิธี Pre-training แล้วค่อยมาปรับ Fine-tune กับงานที่เราต้องการใช้ภายหลังนะครับ ตัวอย่างที่ชัดเจนคือ Google BERT (https://github.com/google-research/bert)

หนึ่งในนั้นที่น่าสนใจก็คือเรื่อง Machine Translation นะครับ ที่ไม่ต้องใช้เนื้อหา Translation Pair ในการสอน AI แล้ว เพียงแค่นำ Pre-training ของแต่ละภาษามาแล้ว AI จะหาคู่คำแปลได้เองอัตโนมัติด้วยเทคนิคการ Map ให้ Word-Embedding ตรงกันนะครับ ทำให้เราสามารถทำ Machine Translation ได้ด้วยต้นทุนที่ถูกลงมากเลยครับ หากใครสนใจไปลองอ่าน Facebook XLM ดูนะครับ (https://github.com/facebookresearch/XLM)

เรื่อง Speech นะครับ ตอนนี้เค้าสามารถสร้าง Speech Model ด้วยเทคนิค Pre-training โดยให้ AI ฟังเสียงตัวอย่างการพูดจากคนหลายๆพันคนนะครับ โดยที่ไม่ต้องมี Text Script ที่ควบคู่กับเสียงแล้วนะครับ และสามารถสร้างตัว Text-to-Speech (TTS) เป็นเสียงของใครก็ได้ ขอเพียงแค่มีตัวอย่างเสียงของผู้พูดที่เราต้องการเพียงแค่ 5 วินาทีเท่านั้น สามารถลองไปดูรายละเอียดเพิ่มเติมที่ https://github.com/CorentinJ/Real-Time-Voice-Cloning ได้เลยนะครับ

หัวข้อที่ 2 โอกาสใหม่ๆครับ ในปี 2020 เราจะเริ่มเห็นหุ่นยนต์มากขึ้นเรื่อยๆ ในปี 2025 เราจะเห็นหุ่นยนต์จนชินตา และคาดว่าจำนวนประเภทหุ่นยนต์จะมากกว่าจำนวน Species ของสัตว์ทั้งหมดในช่วงปี 2030 เราจะเห็นบริษัททางด้านหุ่นยนต์เติบโตขึ้นมหาศาลครับ อาทิเช่น หุ่นยนต์ทำความสะอาด,​หุ่นยนต์ประจำบ้าน, Smart Speaker และโอกาสต่างๆจากหุ่นยนต์ก็มหาศาลเช่นกัน อาทิเช่น

  1. งานการเขียนโปรแกรม AI เพิ่มความสามารถหุ่นยนต์ในด้านต่างๆ ความต้องการ
  2. ระบบศุนย์รวมข้อมูลและ Control ผ่านระบบ IOT ที่สามารถเชื่อมโยงหุ่นยนต์เข้าไว้ด้วยกัน
  3. ระบบ Big Data ที่ทำให้ AI เข้าใจข้อมูลมากยิ่งขึ้น จนกระทั่งรู้ใจลูกค้ามากยิ่งกว่าตัวลูกค้าเอง เราจะสามารถสร้าง Personalize Marketing ซึ่งจะช่วยสร้างเม็ดเงินมหาศาลจากความสามารถเหล่านี้ครับ

ส่วนประเทศไทยต้องเริ่ม Focus จากฐานการผลิตชิ้นส่วนรถยนต์เครื่องยนต์ที่ใช้นำมัน มาเป็นการผลิตชิ้นส่วนหุ่นยนต์ หรือตัวหุ่นยนต์เองได้แล้วนะครับ (รถยนต์ไฟฟ้าใช้ชิ้นส่วนไม่กี่ชี้นเอง และมักจะผลิตเป็นเนื้อเดียวกันแต่แรก) จะและต้องเร่งให้บริษัททางด้าน IT และ Software House ต้องสามารถใช้งาน AI ได้เป็น พร้อมตอบรับความต้องการของลูกค้าที่มีมากขึ้นในปี 2020 นะครับ

หัวข้อที่ 3 คือเรื่องการแข่งขันนะครับ ก็ค่อนข้างชัดเจนว่า งานที่ถูกสร้างเพราะการมาถึงของ AI จะเพิ่มตำแหน่งงานมากถึงประมาณ 133 ล้านตำแหน่งนะครับ แต่ก็จะทำลายตำแหน่งงานเก่าๆ ที่มาถูก AI ด้วยประมาณ 75 ล้านตำแหน่งเช่นกัน ในประเทศไทยจะมีปัญหาใหญ่มากๆ อันนึงก็คือปัญหา Skill Gap ครับ คือคนที่ทำ AI ได้ จะถูกแย่งตัวกันมาก และคนที่ทำ AI ไม่ได้ จะใช้เวลานานพอสมควร (3 เดือน — 1 ปี) กว่าจะสามารถมาเรียนรู้จนมาทำ AI ได้ คนที่ทำไม่ได้ จะหางานยากขึ้นกว่าเดิมมาก (เพราะตำแหน่งลดลงไปถึง 33%) ส่วนคนที่ทำได้แล้ว จะมีความต้องการเพิ่มขึ้นเป็น 2 เท่าในปี คศ. 2022

คนไทยมีปัญหาในเรื่องพื้นฐานความรู้สำหรับงาน AI ค่อนข้างมาก (ขาดทักษะ STEM) จะส่งผลให้คนจำนวนมากตกที่นั่งลำบากในอนาคตอันใกล้นี้ครับ วิธีการแก้ไขก็คือกลับไปทบทวนวิชาคณิตศาสตร์และคอมพิวเตอร์ครับ เพราะ AI คือใช้คณิตศาสตร์เป็นหลัก จำพวก Linear Algebra, Differiential Equation และทักษะทางด้าน Programming โดยเฉพาะภาษา Python ที่สามารถนำมาเขียน AI ได้ดีที่สุดนะครับ

รายละเอียด Slide ทั้งหมดสามารถดูได้ที่ Slideshare ด้านบนนะครับ

หากท่านชอบ Blog ความรู้แบบนี้ฝากกดรูปตบมือ หรือ ช่วยแชร์บทความลง Social Network ที่ท่านชื่นชอบได้เลยครับ

ขอบคุณครับ

หากใครสนใจอยากจะพัฒนาหรือต้องการที่ปรึกษาด้าน AI สามารถเข้าไปดูผลงานของบริษัทเรา iApp Technology ได้ที่ https://iapp.co.th และ https://ai.iapp.co.th หรือติดต่อได้ที่ kobkrit@iapp.co.th ได้เลยนะครับ #Ai #iApp

https://ai.iapp.co.th

ดูเพิ่มเติมได้ที่ https://iapp.co.th และ https://ai.iapp.co.th :D


ศักยภาพของ AI สู่โอกาสใหม่แห่งการแข่งขันและความสำเร็จ (รายงานความก้าวหน้าของ AI ในช่วงปี 2019) was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.