ข้ามไปยังเนื้อหาหลัก

[LLM 4/10] DPO: เมื่อโมเดลภาษากลายเป็น reward model ของตัวเอง

· อ่าน 7 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่แล้วเราทำ RLHF ด้วย PPO และคุณคงเห็นแล้วว่ามันมีชิ้นส่วนเยอะแค่ไหน — ต้องเทรน reward model แยกหนึ่งตัว ต้องโหลดโมเดลพร้อมกัน 4 ตัวใน VRAM ต้องจูน PPO อีกสิบกว่าพารามิเตอร์ และถ้า reward model เพี้ยน โมเดลจะไปเจอทางลัดที่โกงคะแนนได้ บทนี้เราจะทำสิ่งเดียวกันด้วยลูป training ธรรมดาแบบ supervised — ไม่มี reward model ไม่มี RL และที่สำคัญคือ มันไม่ใช่การประมาณ เราจะพิสูจน์ด้วยพีชคณิตว่าทั้งสองชิ้นนั้นตัดกันหายไปจริง ๆ

[LLM 5/10] GRPO: ลบ value network ทิ้ง แล้วให้กลุ่มคำตอบเป็น baseline ของกันเอง

· อ่าน 9 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่แล้วเราปิดท้ายด้วยช่องว่างของ DPO: มันจัดอันดับได้เฉพาะคำตอบที่มีคนเตรียมไว้ในไฟล์ ส่วนบทที่ 3 เราจ่ายราคาเต็มของ PPO: โมเดล 4 ตัวใน VRAM และ value network ทั้งตัวที่ต้องเทรนเพิ่ม บทนี้เราจะเอาข้อดีของทั้งสองมารวมกัน — ให้โมเดลสุ่มคำตอบของตัวเองมาเรียนแบบ RL จริง ๆ แต่ลบ value network ทิ้งทั้งก้อน ด้วยข้อสังเกตทางสถิติที่เรียบง่ายจนน่าหงุดหงิดว่าทำไมไม่มีใครคิดก่อน: ถ้าสุ่มคำตอบหลายอันต่อโจทย์เดียวกัน ค่าเฉลี่ย reward ของกลุ่มก็คือ baseline ที่ value network พยายามประมาณอยู่แล้ว และถ้าโจทย์ตรวจคำตอบได้ด้วยโค้ด เราไม่ต้องใช้ข้อมูล preference จากมนุษย์เลย — ศูนย์คู่ ศูนย์บาท

[LLM 6/10] Context Distillation: ย้าย system prompt เข้าไปเก็บในน้ำหนักโมเดล

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

ทุกครั้งที่ผู้ใช้ส่งข้อความหาแชตบอตของคุณ คุณแนบ system prompt ก้อนเดิมยาวหลายร้อย token ไปด้วยเสมอ — ทุก request ตลอดอายุของระบบ จ่ายซ้ำไม่มีวันจบ บทนี้เราจะย้ายความรู้ก้อนนั้นจาก prompt เข้าไปอยู่ในน้ำหนักโมเดลด้วยเทคนิคชื่อ Context Distillation ในเวอร์ชัน on-policy (OPCD) จุดที่สวยที่สุดคือ ครูกับนักเรียนเป็นโมเดลตัวเดียวกันเป๊ะ ๆ — สิ่งเดียวที่ต่างกันคือใครได้เห็น prompt

[LLM 7/10] Model Distillation: คำตอบที่ผิดของครู คือส่วนที่มีค่าที่สุด

· อ่าน 9 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

บทที่ 6 เรากลั่น "บริบท" เข้าไปในน้ำหนักของโมเดลตัวเดิม บทนี้เราจะกลั่น "โมเดลทั้งตัว" ลงไปในโมเดลที่เล็กกว่า สองบทนี้เป็นคู่กันโดยตั้งใจ: context distillation เปลี่ยนสิ่งที่โมเดลรู้โดยไม่ต้องบอกมันอีกต่อไป — model distillation เปลี่ยนขนาดของโมเดลโดยพยายามไม่เปลี่ยนสิ่งที่มันทำได้ และหัวใจของบทนี้ขัดสัญชาตญาณอย่างแรง: สิ่งที่มีค่าที่สุดที่ครูส่งให้นักเรียนได้ ไม่ใช่คำตอบที่ถูก แต่คือวิธีที่ครูผิด — และปุ่มที่ชื่อ temperature คือสิ่งที่ทำให้เรามองเห็นมัน

[LLM 8/10] Guardrails: รั้วนิรภัยที่แท้จริงไม่ใช่โมเดล แต่คือ threshold

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

แชตบอตภาษาไทยที่ผมและทีม deploy ให้ลูกค้าใช้งานจริง ไม่ได้เจอแต่คำถามสุภาพ ๆ — มีคนขอสูตรทำของผิดกฎหมาย มีคนพยายามหลอกให้มันด่าคนอื่น และมีวันที่โมเดลพ่นเบอร์โทรลูกค้าออกมาเอง บทนี้เราจะสร้างระบบป้องกันทั้งสองทิศ: classifier ตรวจ prompt อันตรายขาเข้า และ ตัวกรอง PII ขาออก แต่ประเด็นแกนกลางของบทไม่ใช่ตัวโมเดล — มันคือความจริงที่ว่า guardrail เป็นการตัดสินใจเรื่อง threshold ภายใต้ต้นทุนที่ไม่สมมาตร และตัวเลข "accuracy 94%" ที่คนชอบโชว์กันนั้น แทบไม่มีความหมายเลย

[LLM 9/10] Benchmarking: ตัวเลข accuracy ที่ไม่มี confidence interval คือข่าวลือ

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

ตั้งแต่บทที่ 1 ซีรีส์นี้พูดประโยคเดิมซ้ำทุกครั้งที่รายงานตัวเลข: "accuracy ที่ไม่มี confidence interval ไม่ใช่ผลการทดลอง มันคือข่าวลือ" และสัญญาไว้ว่าจะอธิบายเต็ม ๆ ในบทที่ 9 — บทนี้แหละครับ เราจะไม่เทรนอะไรเลยแม้แต่ step เดียว แต่จะสร้างระบบวัดผลสามโหมดขึ้นจากศูนย์ เอาทุก checkpoint ที่เทรนมาตลอดซีรีส์ขึ้นมาวัดบนข้อสอบไทยจริง แล้วพิสูจน์ว่า การตั้งค่าที่ไม่มีใครเขียนไว้ใน paper เปลี่ยนคะแนนของโมเดลตัวเดิมได้มากกว่าช่องว่างบน leaderboard ที่คนเถียงกัน

[LLM 10/10] Deployment: คุณไม่ได้รอการคำนวณ คุณรอน้ำหนักเดินทาง

· อ่าน 8 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

เก้าบทที่ผ่านมาเราใส่ความรู้ สอนรูปแบบ จัด preference กลั่นโมเดล กันโมเดลพัง และวัดผลอย่างซื่อสัตย์ แต่โมเดลที่ดีที่สุดของเราก็ยังเป็นแค่ไฟล์ checkpoint ที่ไม่มีใครเรียกใช้ได้ บทสุดท้ายนี้เอามันขึ้นเสิร์ฟจริง และพิสูจน์ประโยคเดียวที่ควบคุมทุกการตัดสินใจของงานเสิร์ฟ LLM: การ decode ทีละ token ไม่ได้ถูกจำกัดด้วยพลังคำนวณ แต่ถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ — เราจะคำนวณเพดานความเร็วจาก datasheet ของ GPU ก่อนเขียนโค้ดแม้แต่บรรทัดเดียว แล้วค่อยวัดของจริงมาเทียบ

รวบรวม Link สำหรับเรียนรู้ Transformer สำหรับ SuperAIEngineer Season 3

· อ่าน 3 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

Schedule​

27 Feb 2023

13:00–13:05 แนะนำว่าโจทย์ QA คืออะไร และ Transformer เอาไปอะไรได้บ้าง
13:05–14:00 NLP Core Knowledge
14:00–14:05 — — Brain Break — —
14:05–15:00 Transformer Core Knowledge
15:00–15:05 — — Brain Break — —
15:05–16:00 Colab 1 (Preprocessing + Text Class) + Colab สร้าง QA
16:00–16:15 Q/A Session

— —

28 Feb 2023
09:00–10:00 Colab 2 (NE + POS+ WS + SS)
10:00–10:05 — — Brain Break — —
10:05–11:00 How ChatGPT Build and Works?
11:00–11:05 — — Brain Break — —
11:05–12:00 Colab: Making Your Own ChatGPT (As the way we did on OpenThaiGPT 0.0.1) + Colab: Reinforcement Learning with Human Feedback (RLHF)
12:00–12:15 Q/A Session + OpenThaiGPT Open for Volunteers.

โจทย์ QA​

อะไรคือ QA: https://ai.iapp.co.th/product/thai_automatic_qa
Colab สร้าง QA: https://colab.research.google.com/drive/1inDOJzCh-iG3_aAU-73tq3FzlCwM8nvY

NLP Core Knowledge​

Slide (Basic NLP -> Word Embbeding -> LSTM): https://drive.google.com/file/d/14AVefnJvgaNXWw6wo-kpmHQyjLAikMgp/view?usp=sharing

Transformer Core Knowledge​

Slide​

Slide (Thai NLP in Transformers Era): https://drive.google.com/file/d/1-V-Gy45c7vHQ4GejvWDBHk0w9oJ4z18I/view?usp=sharing

Colab​

Colab 1 (Preprocessing + Text Class): https://colab.research.google.com/drive/1fGKoS1WH6dbw3mYffOgTtdmPN2Wi9doF?usp=sharing
Colab 2 (NE + POS+ WS + SS): https://colab.research.google.com/drive/1CWamaQH1Lgd7mSZ0UZ4jx2AUMAGDpsfq?usp=sharing#scrollTo=cvrnEG4mOm1p

ChatGPT Core Knowledge​

Website​

https://openthaigpt.aieat.or.th/

Slide​

Slide (ChatGPT: How it works?): https://docs.google.com/presentation/d/1Q6_S_GDWHuNC0DfprNMn9EH0kyqK_y-RbdK5fJB6EUk/edit#slide=id.g1f3418062d6_0_156

Slide (OpenThaiGPT):
https://docs.google.com/presentation/d/1JJxtwo1pCJC3u6aSfslSp1FJSb5ZS5xBKIiQ-6Kip_g/edit?usp=sharing

Colab
Finetuning OpenThaiGPT version POC 0.0.1:
https://colab.research.google.com/drive/1MA1FHwknrs6mVstOHcSyFTnDNWrus-G-?usp=sharing

RLHF: สอนให้ Model Generate ข้อความเชิงบวก (Positive Sentiment) ได้มากขึ้นด้วย PPO https://colab.research.google.com/drive/1qce78Q00SY7CKXLVtiSGFbP5C1V_nypn?usp=sharing


รวบรวม Link สำหรับเรียนรู้ Transformer สำหรับ SuperAIEngineer Season 3 was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.

แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple Transformer

· อ่าน 2 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

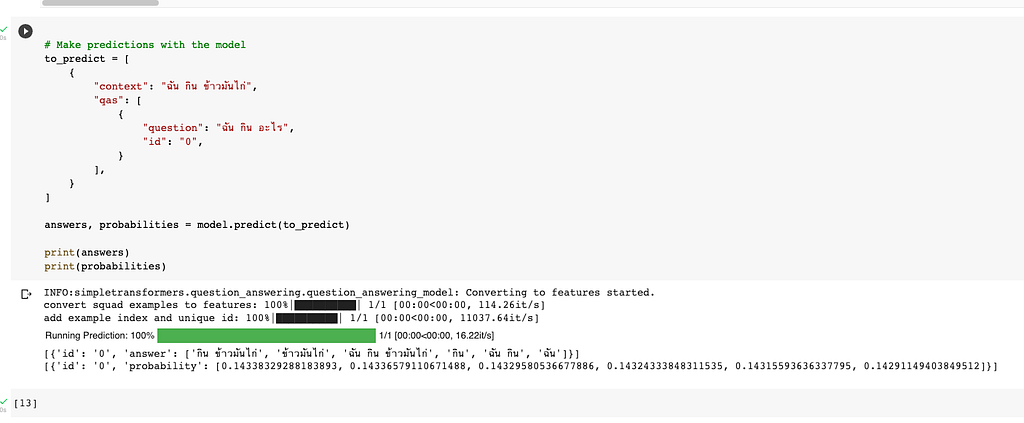
แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple Transformer​

How to make Thai QA System using SimpleTransformer

Colab:

https://colab.research.google.com/drive/1inDOJzCh-iG3_aAU-73tq3FzlCwM8nvY#scrollTo=vLChKnukd3gC


แจกวิธี Train Thai Question Answering AI ใช้ Wangchanberta บน Dataset iApp QA โดย Simple… was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.

แจกไบเบิ้ล วิธีการ Finetune BERT, Roberta, Wangchanberta สำหรับงาน NLP ภาษาไทยแบบง่าย พร้อมแจกโค้ดบน Colab!!

· อ่าน 4 นาที
Kobkrit Viriyayudhakorn
CEO, iApp Technology

แจกไบเบิ้ล วิธีการ Finetune BERT, Roberta, Wangchanberta สำหรับงาน NLP ภาษาไทยแบบง่าย พร้อมแจกโค้ดบน Colab!!​

ชุดซอฟต์แวร์ Transformer จาก Huggingface (https://huggingface.co/) เป็นศูนย์รวม Software, Model และ Datasets ในการใช้ Transformer ทางด้าน NLP ที่ยอดนิยมที่สุดในโลก สนับสนุนทางภาษาไทยและภาษาอังกฤษ และทุกภาษาทั่วโลก

การใช้งานชุดซอฟต์แวร์ Transformer จาก Huggingface นี้ ต้องมีความรู้เฉพาะทางของแต่ละ Model ในตระกูล Transformer และต้องเรียนรู้ API ของ Huggingface ต่างๆ อาทิเช่น Datasets, Trainer, Tokenizer, Inference API ที่ต้องใช้เวลาและการเรียนรู้ค่อนข้างนาน (แต่ก็ดีกว่าไป Clone GIT Repo ของ Transformer แต่ละตัวมาแล้วมาเรียนรู้และเล่นเอง ไปหลายขุมแล้ว)

เพื่อที่จะให้ผู้ที่ทำการเรียนรู้ สามารถนำ Model Transformer นำไปใช้งานได้อย้างรวดเร็ว โดยที่เข้าใจถึงพัฒนาการของงาน NLP จาก One-hot Encoding, Word2Vec, LSTM, Encoder & Decoder และ Transformers ได้ด้วยนั้น

สอน NLP Processing + Toolkits ที่ค่าย Super AI Engineer Season 2 ระหว่างวันที่ 14–15 กุมภาพันธ์ 2565

ทางผมได้รับเชิญ ให้สอนวิธีการพัฒนา AI เหล่านี้ในค่าย Super AI Engineer Season 2 ผู้เข้าร่วมประมาณ 130 ท่าน จัดโดยสมาคมปัญญาประดิษฐ์ประเทศไทย (AIAT) ระหว่างวันที่ 14–15 กุมภาพันธ์ 2565โดยสอนวิธีการสร้าง Model AI ด้าน NLP ตั้งแต่วิธี Basic จนถึงการใช้ Word2Vec, LSTM, BERT, Roberta และสอน Finetune โมโดลโดยการใช้ Tensorflow Keras, Pytorch และสุดท้าย Finetune บนซอฟต์แวร์ชุด Simple Transformer (https://simpletransformers.ai)/ซึ่งเป็นชุดซอฟต์แวร์ที่ที่ทำให้เรา Finetune Model บนข้อมูลบน Pandas ได้โดยง่าย โดยไม่ต้องเขียน Data Class หรือใช้ Data loader บนงาน NLP ภาษาไทยและอังกฤษได้ ซึ่งใน Colab มีตัวอย่างตั้งแต่

  1. Text Cleaning
  2. Text Classification
  3. Text Similarity
  4. Word Segmentation
  5. Name Entity Recognition (NER)
  6. Part of Speech Tagging (POS)
  7. Sentence Segmentation

พร้อมตัวอย่างใช้งานได้จริงผ่าน Notebook บน Google Colaboratory ใน 2 Links นี้

NLP Preprocessing + Text Classification (Monday 14 Feburary)
https://bit.ly/sai2-nlp1

NE + POS + WS + SS (Tuesday 15 Feburary)
https://bit.ly/sai2-nlp2

และสุดท้ายสอนการ Upload Model และ Tokenizer ขึ้นที่หน้าเว็บไซด์ของ Huggingface อีกด้วย ในท้ายของวันที่ 15 Faburary

ใครสนใจลองเข้าไปเรียนรู้ดูได้ หากเจอข้อผิดพลาดอะไร สามารถแจ้งมาที่ได้เลย มาจะทำการ Update แก้ไขให้ครับ

Colab ตัวนี้เป็นแบบ MIT license สามารถใช้ในการแจกจ่าย ดัดแปลง ไปใช้ในทางธุรกิจ อะไรได้หมดเลยครับ ทางผมยินดีครับ ขอบคุณครับ


แจกไบเบิ้ล วิธีการ Finetune BERT, Roberta, Wangchanberta สำหรับงาน NLP ภาษาไทยแบบง่าย… was originally published in Kobkrit on Medium, where people are continuing the conversation by highlighting and responding to this story.